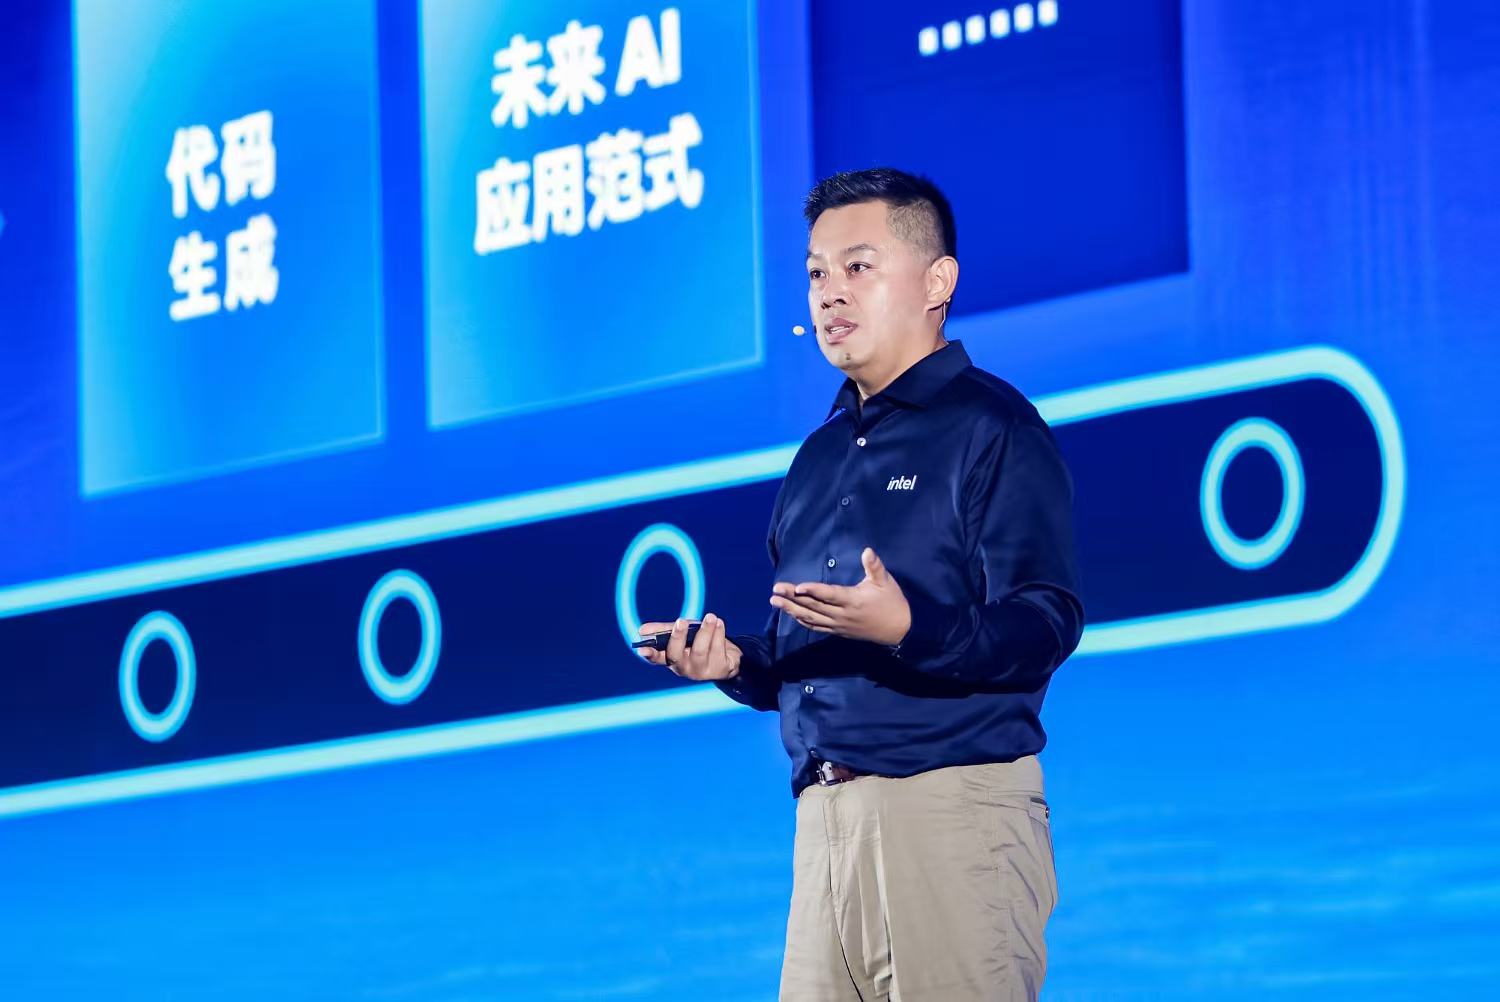
英特尔近日在苏州举办了2026年度技术创新与产业生态大会。英特尔数据中心集团副总裁、中国区总经理陈葆立在主论坛上发表主题演讲指出,AI产业正经历从“Token工厂”向“AI工厂”的转变,未来数据中心将形成由CPU执行集群、GPU智算中心、高性能存储集群共同构成的架构。而随着Agentic AI从概念走向规模化落地,英特尔正通过覆盖计算、加速、存储与软件的全栈技术布局,为智能体时代提供算力底座。在此后举行的媒体访谈中,陈葆立还与英特尔数据中心集团软件工程经理胡勇共同详细解读了英特尔在数据中心中的产品与技术布局。其中特值得注意的是英特尔最新推出的KV Cache智能加速套件,其致力于解决当前智能体推理中存在的大数据量存储瓶颈,以支撑智能体的快速落地。
KV Cache成智能体落地的核心卡点
随着智能体推理应用的日益普及,Token消耗量也在不断提升。数据显示,中国大模型每日 Token调用量已增长至2024年初的5000倍,预计到2031年中国企业场景中的活跃智能体数量将达到3.5亿个。AI负载在数据中心中的占比预计将从2025年的40%攀升至2030年的80%,整个数据中心架构都将围绕AI需求重构。在此情况下,KV Cache的容量爆炸式增长,成为制约智能体性能与部署成本的瓶颈。
对此,陈葆立在主题演讲中特别重点提到了英特尔新推出的KV Cache智能加速套件,其核心方案KV Shrink通过分层卸载架构与硬件级压缩加速,可以大幅降低显存占用,实现存储成本降低与优化多Agent的调度效率。
在后续举行的媒体访谈环节,英特尔数据中心集团软件工程经理胡勇等技术专家,又进一步对技术细节进行了分享。要理解KV Cache为何成为智能体时代的核心痛点,首先要理解其技术本质。KV Cache是大模型推理过程中用于缓存历史Token键值对的机制,通过复用已计算的结果避免重复运算,在传统短对话场景下命中率可达50%至70%,长期以来都是提升推理效率的关键手段。
然而,进入Agentic AI时代,这一机制正在面临前所未有的压力。智能体不再只是简单的问答工具,而需要承担长上下文理解、多轮工具调用、多Agent协同、自我迭代验证等复杂任务,上下文窗口从数千Token跃升至百万Token级别。以标准35B参数模型为例,百万Token上下文对应的KV Cache容量可达数百GB,早已超过主流GPU内置HBM显存的容量上限。
胡勇分析由此带来的困境就是存储容量的天花板,HBM显存的物理容量直接限制了模型可支持的上下文长度与并发用户数。在长上下文、多Agent协同场景下,“显存装不下KV Cache”已成为普遍的部署约束,许多业务不得不通过截断上下文、削减并发规模来妥协。
此外,当成千上万的Agent协同工作时,大量时间被消耗在KV Cache的存储、查找、调度与管理上,而非真正的推理思考与任务执行。这又会增加系统成本。HBM 显存价格昂贵,若单纯依靠堆叠显存来容纳KV Cache,将大幅推高单卡成本与数据中心整 TCO(总拥有成本)。
KV Shrink的缓存资源弹性调度
英特尔KV Shrink方案的核心思路,是打破 KV Cache必须全部驻留显存的固有认知,按照数据访问热度构建分级存储体系,让不同频率使用的KV Cache各归其位,在容量、性能与成本之间录找最优平衡。
根据胡勇的介绍,KV Shrink提供本地节点与远程节点两种部署模式:本地节点部署将KV Cache从GPU显存卸载至AI服务器头节点的系统内存,按需进行压缩存储,调用时解压后回传显存。该模式路径短、部署简单,适用于单节点内对时延敏感的高性能场景。
远程节点部署则通过RDMA高速网络,将显存中 KV Cache传输至远程至强服务器集群进行统一存储与调度,实现存储资源池化与极致的容量弹性,更适合大规模、多租户的云端多Agent协同场景。
在分层策略上,高频访问的热数据保留在HBM显存中保障低时延,中频温数据迁移至系统内存承载,而长期闲置的冷数据(如跨周期的历史对话)才进一步转存至SSD,调用时再逐层回迁,避免不必要的落盘开销。
覆盖全周期的KV Cache技术矩阵
KV Shrink是英特尔KV Cache智能加速套件的重要组成部分。胡勇在分享中指出,英特尔围绕KV Cache的“扩展、压缩、聚焦、复用”全生命周期,构建了一套完整的技术方案,解决HBM的容量问题。
除核心的KV Shrink外,还包括KV Infinity、KV Cascade、KV Fuse等多个方案模块,分别面向容量扩展、层级级联、热点聚焦与缓存复用等不同场景,覆盖从单模型推理到多智能体协同的完整业务链路。
这套体系化方案的一大优势,在于统一的硬件底座与软件生态。所有模块均复用至强处理器内置的IAA、QAT、DSA等硬件加速阵列,保障跨场景的性能一致性;同时软件栈全面兼容,企业无需为不同场景重复适配,降低了技术引入门槛。
面向Agentic AI的算力协同进化
KV Cache加速方案只是英特尔应对Agentic AI时代算力变革的一个方面。在媒体群访环节,陈葆立还围绕CPU架构优化、CPU与GPU分工、集群选型等话题分享了一系列前瞻性判断。
针对大规模Agent部署对CPU提出的全新要求,胡勇介绍,首先是前端架构精细化,优化任务编排调度、操作系统切换与上下文切换,打磨各级缓存效率,以应对Agent负载高密、突发、定制化的特征。
此外,英特尔还将针对沙箱启动、镜像恢复等固定计算模式集成专用ASIC加速;强化RAS可靠性与TDX 加密隔离,防范任务冲突与安全风险;并针对Agent场景的内存密度特征,扩展内存通道与容量支持,匹配单颗CPU承载大量Agent的新需求。
围绕业界关注的CPU与GPU算力配比问题,英特尔认为,二者并非替代关系,而是相辅相成、协同增长。具体而言,GPU承担大模型的思考环节,负责矩阵运算与Token生成,CPU 则承担智能体执行的全链路,包括任务规划、子Agent调度、工具调用、沙箱启停、数据预处理与结果校验。
随着大模型从对话输出走向主动执行,一个主智能体将派生多级子Agent与大量隔离沙箱,执行侧算力需求正快速攀升,未来CPU算力有可能会出现显著的需求缺口。