导语:当 AI 学会"看着你说话"
2026 年 9 月 14 日,总部位于美国西雅图的 AI 研究公司 Nuance Labs 官宣完成 5000 万美元 A 轮融资,由老股东 Lightspeed Venture Partners 领投,Accel、South Park Commons 跟投,NVIDIA(NVentures)与 Define Ventures 作为新进投资人加入。这家由三名前苹果博士研究员创立的公司,要做的事情在今天的 AI 版图上显得颇为"反潮流":不去训练又一个通用大语言模型,而是打造一个单一模型——实时理解并生成语音、面部表情与肢体语言的"人类对话与表达"视听基础模型。
之所以说反潮流,是因为当前 AI 与人的交互主流仍然停留在"听写"层面:语音助手听得见你说话,却看不见你的表情;数字人笑容可掬,却常常在你话未说完时呆滞卡顿。Nuance Labs 的创始人方昌邺(Fangchang Ma)在融资公告中说,AI 与数字人的潜力之所以远未兑现,正是因为"它们呆滞地盯着你,或者不断打断你"。
本文认为,这笔 A 轮的意义不在于 5000 万美元本身——在今天的 AI 融资市场这只是一笔中等规模的交易——而在于它标记了一个可能的赛道起点:视听基础模型(audiovisual foundation model)。语音 AI 已经长大,而面对面的 AI 尚未出生;Nuance Labs 押注的,正是这个"中间地带"。本文将沿"赛道—技术—竞争—资本—前景"五个维度,剖析这笔交易背后的产业逻辑与风险敞口。
引子:一笔标志性 A 轮
先把事件本身的细节钉牢。
金额与轮次:Nuance Labs 近日宣布完成 5000 万美元 A 轮融资,由老股东 Lightspeed Venture Partners 领投,Accel 与 South Park Commons 继续跟投,英伟达旗下投资部门 NVentures 及专注数字健康的 Define Ventures 作为新投资方加入;加上 2025 年完成的 1000 万美元种子轮,公司累计官宣融资额达 6000 万美元(注:SEC Form D 披露的实际售出金额约为 5645 万美元,其中 A 轮 4670 万美元、种子轮 975 万美元,该数据与官宣口径因统计方式不同存在差异)。
资本动作早于官宣。一笔值得玩味的细节是:据 SEC Form D 申报文件(CIK 0002077873)披露,Nuance Labs 本轮募资的首笔证券销售始于 2026 年 3 月 12 日,早于 9 月 14 日的官方宣布约半年;截至 3 月 26 日申报时,已售出证券约 4670 万美元(发行总上限约 6080 万美元,尚有约 1415 万美元未售出),且 Lightspeed 合伙人 Nnamdi Iregbulem 已列名为公司董事。
资金用途:官方口径称本轮融资将用于加速模型研发。
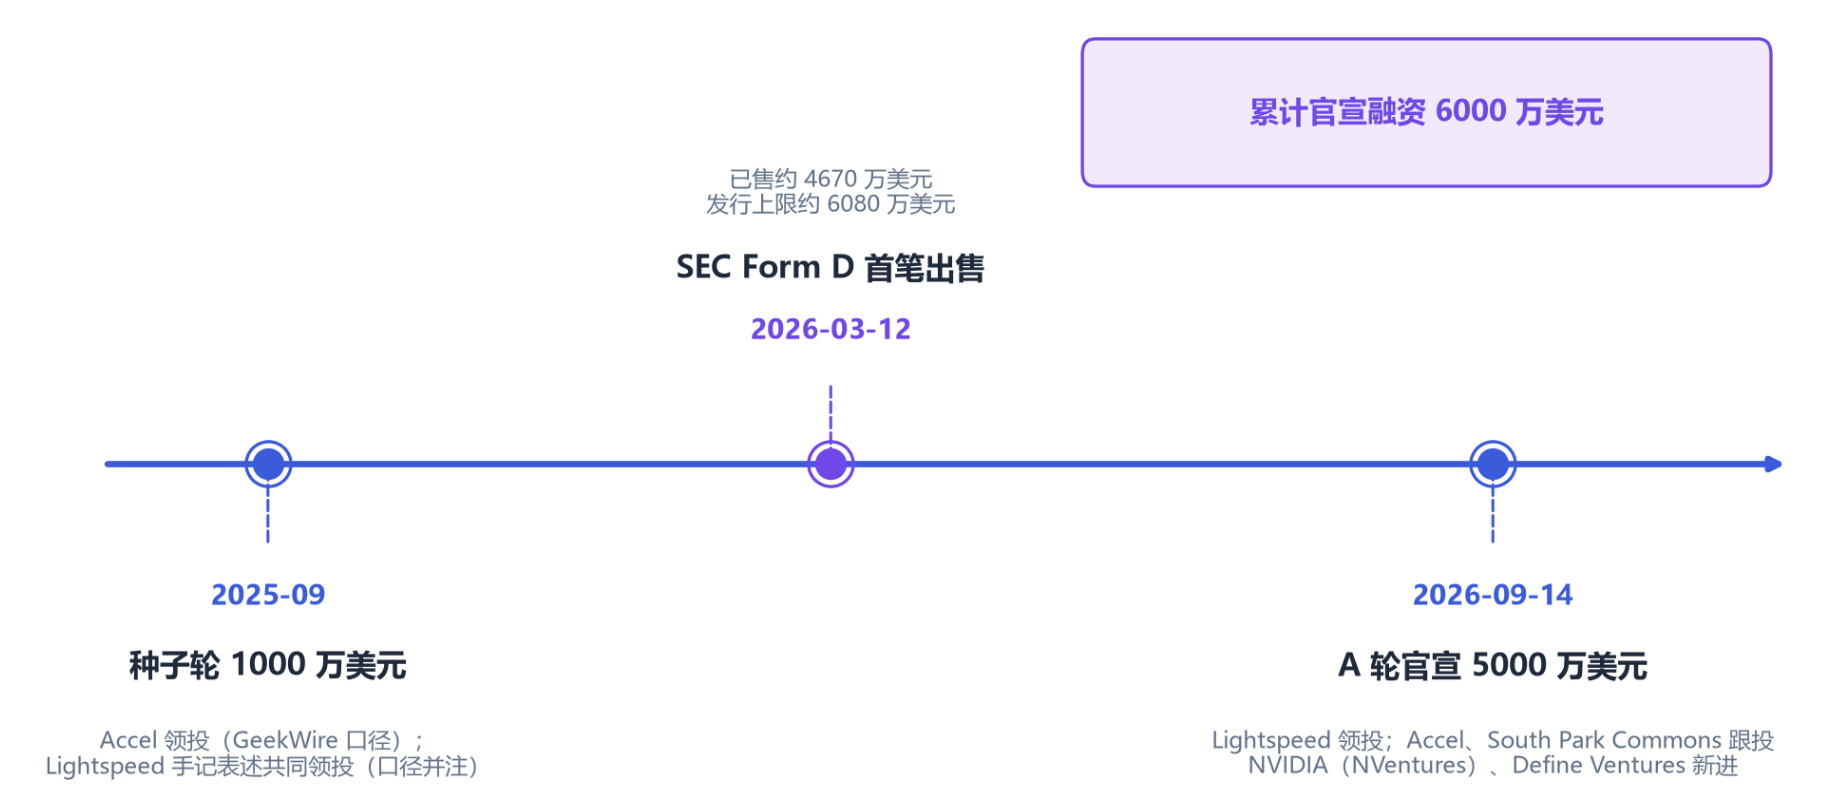
图 1 Nuance Labs 融资路径时间轴(2025-09 种子轮 → 2026-03 SEC Form D → 2026-09-14 A 轮官宣)
创始人的一句话:在公告中,Ma 表示:“最高效的协作,来自你能自由地表达自己——用词、语气、手势和表情,就像跟朋友或关系近的同事说话那样,一来一回里所有的细微差别,把交谈变成了理解。这就是我们在Nuance Labs做的东西:AI理解我们表达自己的多种方式,并像一个人那样,在当下做出回应。”
赛道定义与边界:视听基础模型是什么,不是什么
讨论任何新兴赛道,第一步是划清边界。"视听基础模型"极易与四个相邻概念混淆,而 Nuance Labs 恰好处在它们的交汇处却又不属于任何一个。
第一,它不是"数字人"(Digital Human / Avatar)。主流数字人公司的核心命题是"生成的形象够不够逼真"——把一张会动的脸做到以假乱真,再把语音合成接上去。Nuance Labs 的命题则是"交互够不够即时和自然":据其官方公告描述,模型需要在对词、语气、注视、手势、时机的全谱感知中实时生成回应。换句话说,数字人赛道卷的是"外观保真度",Nuance Labs 卷的是"交互时间轴"。RuntimeWire 的报道一针见血:该公司正在用基础模型的投入,去解决面对面 AI 缺失的底层机制——时机、注视、语气与打断。
第二,它不是"语音助手"的升级版。语音助手(无论是否接入大模型)的输入是音频转文字后的文本,输出是文本转语音。Nuance Labs 官方公告明确反对这种范式:只看文字转写的 AI 只能基于用户意图的残缺画面工作;而"当 AI 表现出它在倾听时,人们会说更多、说得更自由"。这意味着其输入从"说了什么"扩展到"怎么说的"——表情、姿态与语气都是信息,这在语音助手的技术框架内无处安放。
第三,它不是"Emotion AI 分析工具"。市场上已有大量情绪识别类公司,输出的是情绪标签、注意力评分等分析结果,供下游系统消费。Nuance Labs 的模型不只是"读"情绪,而是"读且答"——在同一模型内以语音与表情实时回应。它站在分析工具的上游:分析是它的输入端能力,而非终点。
第四,它也不是通用多模态大模型的一个功能模块。当前主流多模态模型(能看图、能说话的 LLM)的视听能力是通用能力的延伸,交互通常仍是"轮流制"——你说完、我作答。Nuance Labs 主张的是专用(specialized)模型路线:据 GeekWire 种子轮报道与 TinyTechFund 的跟踪,其路线是将自回归 transformer 延伸至音视频 token,把人类视频压缩为 token 逐帧预测;专用模型相对通用 LLM 训练更经济、推理更快。
在多模态版图中,它占据的位置可以这样描述:若把 AI 与人的交互按"通道丰富度"(纯文本 → 语音 → 音视频)与"交互时序"(轮流制 → 全双工实时)两个维度展开,今天的语音助手与数字人大多位于"语音/音视频通道 × 轮流制"象限,而 Nuance Labs 押注的是"音视频通道 × 全双工实时"象限——一个目前几乎无人的位置。本文认为,这个定位解释了该赛道的吸引力与风险的同源性:无人区意味着定价权,也意味着没有可对标的技术参照系。
技术演进脉络:从"拼接管线"到"全双工单模型"
理解 Nuance Labs 的技术主张,需要先看清它所批判的现状。
拼接管线的三个断裂点。当前几乎所有 AI 数字人/语音交互产品采用的都是模块化管线:语音识别把音频转成文字 → 大语言模型决定说什么 → 语音合成生成声音 → 面部动画系统驱动表情。Nuance Labs 在官方公告中指出,这条管线的问题是结构性的:每一次"交接"都会丢失信息、增加延迟——语气、迟疑、注视与手势可能永远到不了语言模型,而数字人在管线产出完整回应之前往往静止不动,最终表现为"呆滞、打断、跟不上"。
全双工单模型的架构主张。Nuance Labs 的替代方案是全双工(full-duplex)单模型:视听感知流入与视听响应流出生成同时进行,系统可以在用户仍在说话时就以语言与非语言线索表明"我在听",实时响应内建于架构本身、而非外挂于管线之上。Ma 对此的概括是"一个系统、一个模型,音视频进、音视频出"。
自回归 token 路线。从公开的技术描述看,这条路并非凭空发明,而是把语言模型已被验证的自回归范式推广到视听模态:将人类视频压缩为 token,逐帧/逐 token 预测。GeekWire 在种子轮报道中即披露了这一路线,TinyTechFund 的跟踪材料亦印证。这条路线的产业含义在于:它复用了当前 AI 算力生态最成熟的推理范式——这或许也部分解释了 NVIDIA NVentures 的参投逻辑。
实时性:最硬的那根骨头。全双工交互对推理延迟的要求远高于轮流制对话。据第三方跟踪机构 TinyTechFund 的口径,Nuance Labs 的目标是亚 500 毫秒(sub-500ms)响应延迟,并让模型具备"主动聆听"行为(如适时点头、发出附和音)——需要强调的是,这一数值为第三方跟踪口径,公司官方并未给出具体延迟指标,其可行性与最终表现有待 2026 年内研究预览的公开检验。实时音视频 token 推理对算力与工程优化的要求,正是其招聘岗位中"推理与实时服务""模型优化"密集出现的原因。
数据壁垒:赛道真正的护城河。如果说架构与算力可以用钱解决,数据则未必。Ma 在采访中披露:这类模型的训练数据无法从互联网爬取——理想数据是双方面对面自然对话的音视频,要求音轨干净分离、自然而非表演性质——因此公司采取自建数据与数据合作方并行的策略。本文认为,这是理解这家公司长期竞争位置的关键:互联网上不存在"面对面真实对话"规模化的公开语料,谁先建成这条数据管线,谁就握住了赛道最稀缺的资产。这也与官方招聘中"数据基础设施""人类评估"岗位的分量相互印证。
小结:从技术演进看,Nuance Labs 的叙事可以概括为一条清晰的路线跃迁——把"感知-决策-生成"的串行管线,重构为"感知即生成"的全双工单模型。这一主张在逻辑上自洽,但其成立的前提(低延迟、数据规模、表达连贯性)尚未经任何公开检验。
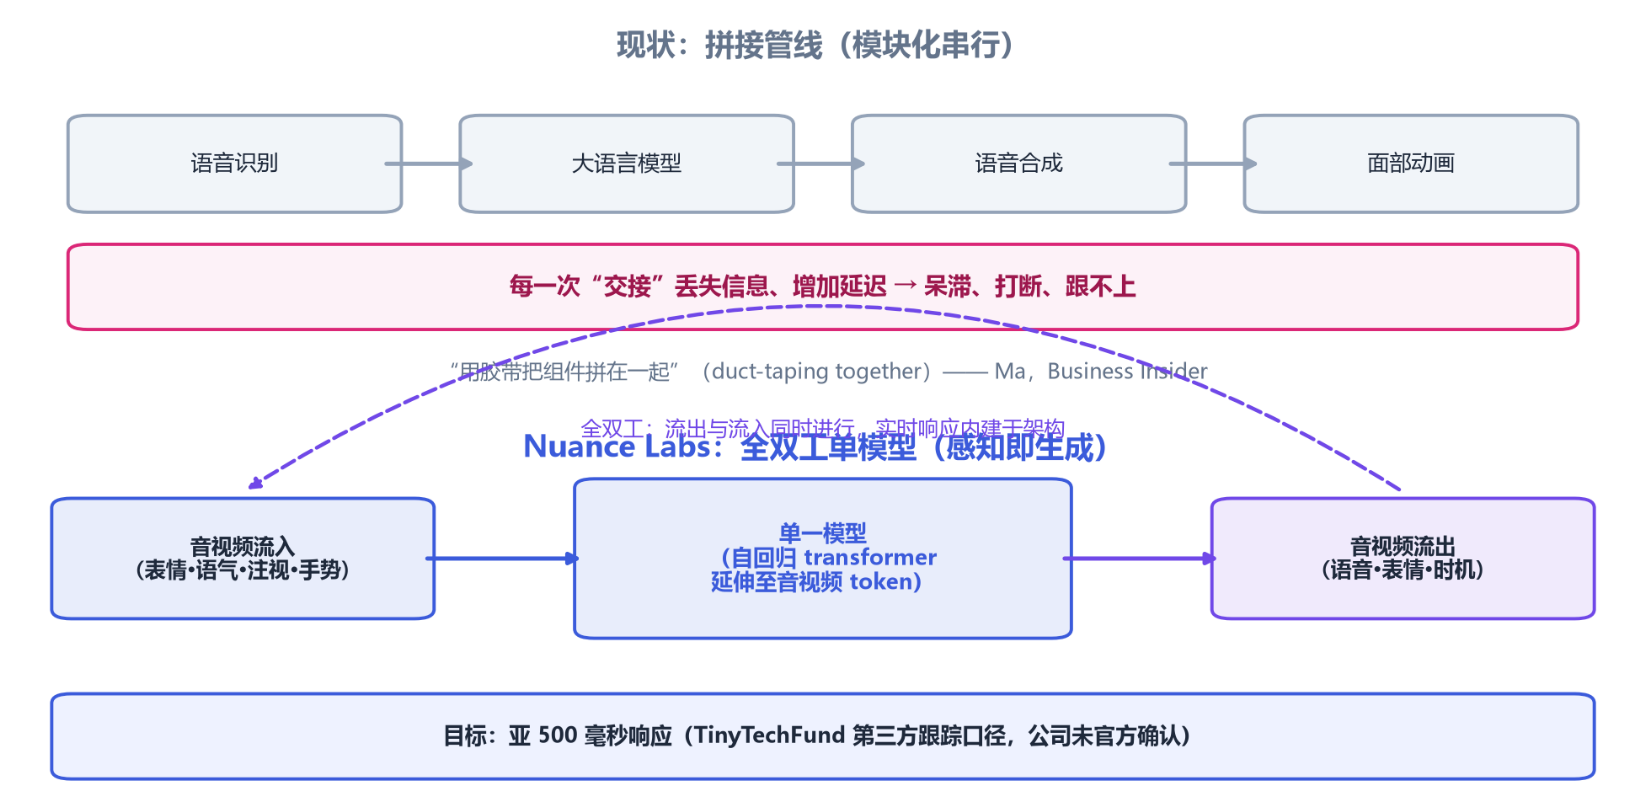
图 2 拼接管线 vs 全双工单模型架构对比(虚线为全双工双向流)
需求驱动与市场空间:情绪是尚未定价的交互资源
市场有多大:两个口径,一个共识。
先看 AI Avatar(数字人/虚拟形象)市场。不同研究机构因定义边界差异,给出的规模数据差距明显,须如实并注:
· 窄口径:据 Global Market Insights(GMI)研究,AI Avatar 市场 2025 年约 63 亿美元,2026 年约 84 亿美元,预计 2035 年达 934 亿美元,2026-2035 年复合年增长率 30.6%。
· 宽口径:据 Precedence Research(2026 年 3 月),该市场 2026 年约 129 亿美元,预计 2035 年达 1426 亿美元,CAGR 30.73%。
· 口径差异说明:不同机构对 avatar/digital human 的定义差异较大,2032-2035 年的预测值大体分布在数百亿至 1500 亿美元量级(上限约 1550 亿美元有 Market Research Future 旁证,下限来源权威性不足,仅作趋势参考),但所有口径均指向 30% 以上的年增速。
再看 Emotion AI 与情感计算——这正是 Nuance Labs 定位所直接触达的市场。按第三方市场研究口径,Emotion AI 市场 2025 年约 33 亿美元,2026 年约 41.6 亿美元,预计 2034 年达194亿美元,CAGR 22.3%。
更宽泛的"情感计算(affective computing)"口径(含软硬件),据 Grand View Research(2026 年 4 月),2025 年全球市场规模约 1024 亿美元,2026 年约 1337 亿美元,预计 2033 年达 8666 亿美元,2025–2033 年 CAGR 约 30.6%;IMARC Group(2026 年 2 月)口径更宽,预计 2034 年可达约 9266 亿美元。
应用结构上,医疗健康、零售与营销为前两大垂直领域,汽车(含驾驶员状态监测、车内情绪交互等)为增速最快的核心场景之一。
本文认为,解读这些数字的正确方式不是记住某个具体规模,而是注意到结构性事实:各机构在"口径分歧巨大"的前提下,对增速的判断高度一致(22%-31%)。这意味着赛道处于典型的早期陡峭增长段,规模数字的不确定性反而说明格局未定——对初创公司而言,"没有公认的市场地图"既是融资叙事的挑战,也是定义赛道的窗口。
需求端的三重驱动(基于官方与媒体素材归纳):
其一,交互摩擦是真实痛点。Ma 的"呆滞盯着你、不断打断你"之问,正因为它描述的是每个用户都经历过的体验。
其二,"被倾听"改变行为。创始人表述了一个值得关注的机制性论断:当 AI 表现出在倾听时,人们会说更多、说得更自由。若该论断在真实场景成立,则全双工模型在销售、教育等"对话产出"型场景中的价值将远超话术正确的轮流制模型。
其三,表达即产出。将应用场景指向销售与客服、教练/辅导、专业培训、教育——这些场景的共同特征是"表达质量直接决定结果",且 AI 定位为与人协同工作而非替代。
商业模式的两层结构:除自建 B 端应用外,Nuance Labs 表达了平台化野心——据 RuntimeWire 转述,公司希望提供"一个其他产品可以构建其上的交互层(interaction layer)",叠加自身开发的应用。若以交互层定位兑现,其对标对象将不是某家数字人公司,而更接近平台型技术提供商,是今天语音接口在应用生态中的位置。
竞争格局与玩家坐标:三条路线上的卡位
巨头动向:三位创始人均为前苹果博士研究员,创始团队曾在苹果从事"机器如何感知与重建人"的研究——其中Fangchang Ma与Edward Zhang直接参与了Vision Pro的Digital Persona(数字分身)系统的构建;官方公告与多方报道均指出,远程呈现(telepresence)中逼真重建一个人尚且是难题,遑论在实时对话中跟随语言与非语言线索的交织。这段经历至少说明一点:巨头内部也在攻这个问题,但选择出来创业的三个人认为单模型路线值得独立验证。
数字人头部公司:三条不同的产品路线。以规模论,当前可比的三家公司与 Nuance Labs 形成有趣的坐标系:
· Synthesia:2026年1月完成2亿美元E轮融资,估值40亿美元,GV领投、NVentures参投。约90%的Fortune 100为其客户,ARR约1.5亿美元量级。其路线是企业级视频内容生产——"让企业用数字人拍培训视频",本质是内容生成工具。
· HeyGen:据2026年6-8月口径,ARR超2亿美元(8个月内翻倍);2026年4月发布Avatar V;此前于2024年6月完成6000万美元A轮(Benchmark领投);"每1美元股权融资产生约2.70美元ARR"。其路线同样是内容生成与营销视频,且已验证了数字人产品的变现效率。
· D-ID:2026年3月16日发布V4 Expressive Visual Agents,对话延迟低于0.5秒、支持LLM连接、4K输出与情感感知的表情控制;服务约1500家企业客户,截至V4发布时其平台上已累计创建超过80万个visual agents。值得关注的是,D-ID的V4已在"低延迟+情感表达"上与Nuance Labs的主张出现交集——这是目前与"实时表达"路线最接近的产品级玩家,但其架构是否为端到端单模型,公开资料中未见说明。
本文认为,竞争坐标可以这样概括:Synthesia与HeyGen验证了"数字人内容生成"的商业可行性(ARR 1.5亿-2亿美元级),但它们解决的是"生产一段视频"的问题,不是"进行一场对话"的问题;D-ID开始向对话式agent演进但路线未明;Nuance Labs则从一开始就把自己放在"对话"而非"内容"的位置上。两条路线的市场规模口径可以互相借用,但技术栈与护城河完全不同——后者的门槛在实时推理与对话数据,前者的门槛在生成质量与分发渠道。
Nuance Labs 的卡位分析。综合分析,其卡位优势有三:一是定位独占性——"全双工视听基础模型"在公开信息中尚无直接对位的同路线公司;二是团队与问题的匹配度——创始团队在苹果的Digital Persona与远程呈现研究恰是该问题域的最前沿经验;三是资本与算力生态的背书——Lightspeed连续两轮加注、NVIDIA参投。相应地,其劣势同样清晰:pre-product阶段(尚未发布产品,仅有demo,计划2026年晚些时候开放公开研究预览)、团队规模(24人)远小于头部数字人公司、且无已验证的收入模型。
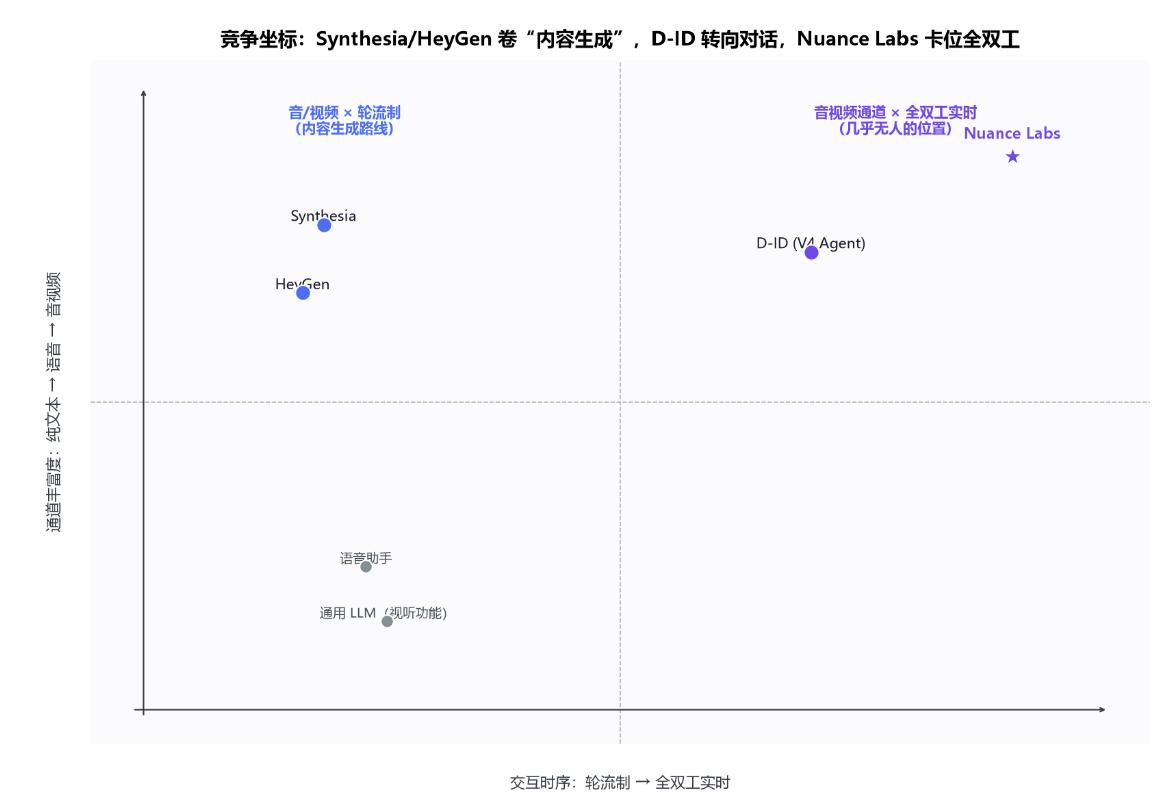
图 4 竞争坐标象限:通道丰富度 × 交互时序(定性示意)
资本视角:三次下注与两份投资论文
从种子轮到 A 轮的资本路径。种子轮 1000 万美元,由 Accel 领投,Lightspeed、South Park Commons 参投。A 轮则由 Lightspeed 单独领投,这一变化本身即是信号:不到一年半间,领投权从 Accel 移交 Lightspeed,老股东全部跟投,无一退出。
Lightspeed 的"EQ 论文"。Lightspeed 在其投资手记中提出了一个值得记录的论点:智能(IQ)正在商品化,情商(EQ)是下一个战场;其在 portfolio 页将 Nuance Labs 描述为"构建实时人类基础模型,为语音、面容与身体带来社交与情感能力"。Iregbulem 在 A 轮相关声明与媒体报道中表示,Nuance Labs 在构建一个"能像人一样看见并回应人"的界面,并认为该模型将成为 AI 产品的核心层。Accel 亦发布过题为"How Nuance Labs is Building AI's EQ"的文章。两大一线基金在种子轮阶段即形成高度一致的"EQ 叙事",且在 A 轮继续加码,说明该叙事已通过其内部尽调检验。
NVIDIA NVentures 的意图。NVentures 组建于 2021 年,负责人 Mohamed Siddeek;据 Tracxn 统计口径,截至 2026 年中累计投资约 80 家公司、孵化 20 家独角兽,过去 12 个月完成 43 笔新投资,投资以跟投/Pro-rata 跟投为主,核心布局覆盖生成式 AI、AI 基础设施与 CUDA 生态、医疗健康、机器人与自动驾驶四大赛道。英伟达体系(NVIDIA/NVentures)近期同类出手包括:Synthesia E 轮(2026 年 1 月,NVentures 参投)、Runway E 轮(2026 年 2 月,NVIDIA 参投)、Suno C 轮(2025 年 11 月,NVentures 参投)、Tensormesh(2026 年 5 月,NVentures 参投)。本文认为,NVentures 参与 Nuance Labs A 轮的逻辑与投 Synthesia 一脉相承:全双工音视频 token 推理若成为主流交互范式,将带来远超纯文本对话的持续算力消耗——投资卡位与算力需求的培育互为因果。此外,2026 年 3 月提交的 SEC Form D 文件申报募资额约 4670 万美元,且按规则仅披露董事与高管关联方、未列入 NVentures,而 9 月官宣名单中 NVentures 正式在列——这一时序细节侧面印证本轮发行于 2026 年内启动,NVentures 为发行中后期加入的战略投资方。
Define Ventures:一个容易被忽略的信号。Define Ventures 是专注数字健康赛道的基金。据 WOWTALE 的分析,其参与本轮被解读为"表情/语气读取技术切入医疗健康场景(如教练、治疗)"的信号。本文认为这一解读值得重视:若情绪感知交互在健康场景(心理咨询、康复辅导、健康教练)中成立,其付费意愿与使用深度都将高于泛娱乐场景——这或许是本轮结构中最具想象力的一颗棋子,但需待后续动作验证。
综合来看,6000 万美元累计融资、三家头部机构连续两轮下注、一家芯片巨头战略参投——资本结构本身构成了对该赛道可行性的多重背书;但资本叙事与技术现实之间的距离,最终要由下一章讨论的公开检验来度量。
前景推演与风险:预览版是第一张考卷
2026 年研究预览:第一个公开检验。官方口径明确,公司计划于 2026 年内向公众开放研究预览,公司官网与公开报道均预告了预约体验通道。对一家 pre-product 公司而言,这次预览的分量远超常规的"产品发布":它将第一次公开检验本稿第三章所述的全部核心主张——单一视听模型能否在真实对话中做到足够快的响应,同时保持身份一致性、表情连贯与语音自然;以及,读取面部与声音线索真的能产出更有用的交互,还是又一场精致的 avatar 演示。一个关键问题在于:预览将回答"这究竟需要一种新模型,还是仅仅需要更好的产品工程"。
商业化与 GTM:刻意留白的下一步。截至 A 轮官宣,公司尚未发布任何产品,收入为零;据 Business Insider 对 Ma 的采访,研发团队扩张之后,下一步计划才是招聘 GTM(市场进入)专家、确定定价与变现策略。这意味着在可见的 12 个月内,公司的全部资源都将压在模型与预览上,商业化决策被有意后置。对基础模型公司而言这是标准打法,但也意味着投资人下一轮的判断依据几乎只有预览的技术表现与数据指标。
监管风险:情绪识别是敏感区。必须指出,本赛道踩在监管的高压线上:欧盟《人工智能法案》(AI Act)对情绪识别作出严格限制——在工作场所与教育机构中使用 AI 推断个人情绪属于 Article 5(1)(f) 直接禁止的 AI 实践(仅医疗与安全场景例外);其他场景下,情绪识别系统被列入 Annex III 高风险清单(第 1 点(c) 项),原则上须履行高风险合规义务(除非依 Article 6(3) 自行评估并记录排除),并依 Article 50 对暴露人群负透明度告知义务(来源:EU AI Act 原文,eur-lex.europa.eu)。其中,禁止性条款已于 2025 年 2 月 2 日正式生效,高风险系统的合规义务预计于 2027 年 12 月全面适用。 一个实时读取用户表情与语气并作出回应的系统,与"情绪识别"的边界如何划定,将直接影响其在欧盟市场的准入路径;若延伸至员工或学生场景,甚至可能触碰禁令红线。对于把"读取情绪"写进产品定义的公司,这不是可以后置的合规问题,而是架构与产品设计阶段就需内化的约束。
执行风险的注脚:团队规模的口径之惑。一个如实披露的细节:团队规模存在多个口径——种子轮官宣时核心团队为 3 位创始人;A 轮官宣之际,Ma 在采访中提及团队已扩张至约 8 人;而据公司官网与公开报道,目前团队约 20 余人,涵盖研究者、工程师与运营人员。三个口径的差异或因统计时点与口径不同(全职研究员 vs 含运营、核心团队 vs 全员),但本文认为,这一细节的实质含义在于:一家与 Synthesia(估值 40 亿美元)同台叙事的公司,其执行主体仍是数十人量级的团队——基础模型所需的数据管线、推理工程、评测体系与 GTM 能力,都要在极小的人力基数上并行建设。这是所有"小团队做大模型"叙事共同的结构性风险,Nuance Labs 并不例外。
前景推演:本文认为,未来 12-18 个月该赛道的关键观察点有三——其一,2026 年预览版的延迟与表现是否达到可对话级别(技术验证);其二,waitlist 用户中是否出现明确的垂直场景自发聚集(需求验证),尤其关注 Define Ventures 入局所指向的健康场景是否率先跑通;其三,英伟达是否在算力供应与生态层面提供战略支持(生态验证)。三点齐备,则"视听基础模型"从叙事变为赛道;反之,累计 6000 万美元融资也可能成为一条昂贵的技术路线验证费用。
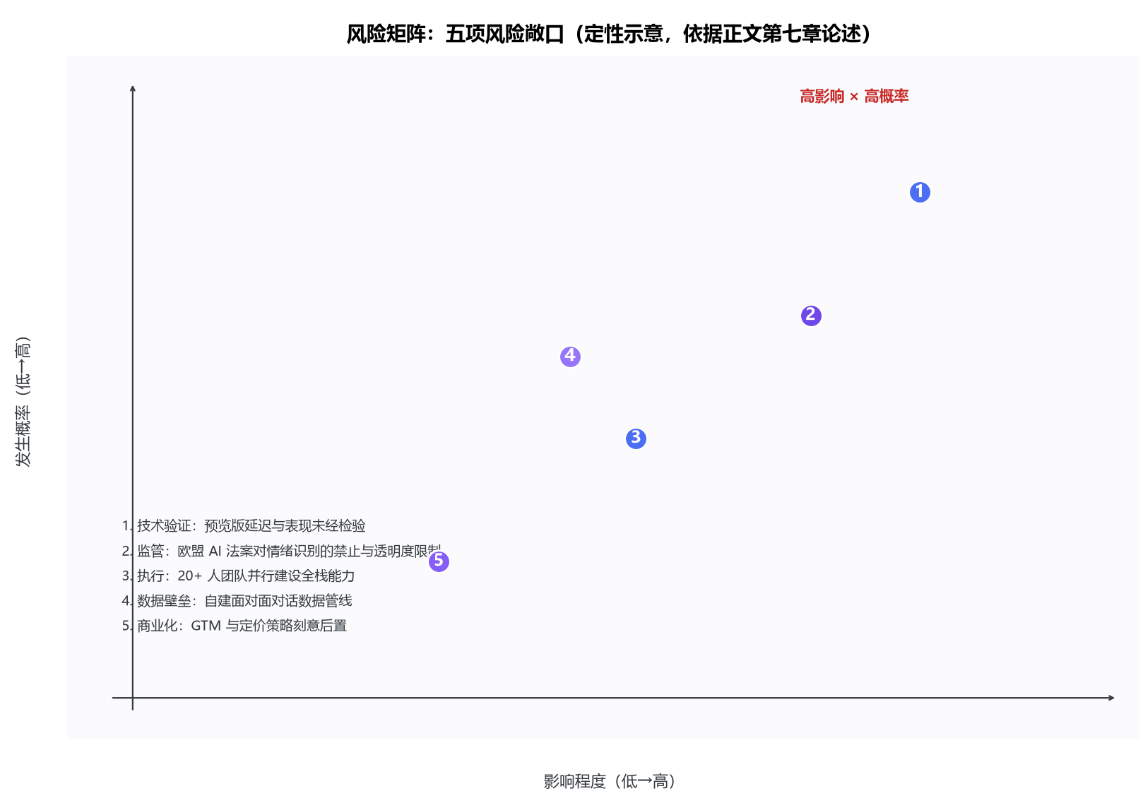
图 5 风险矩阵:五项风险敞口的概率-影响定位(定性示意)
结语
一笔 5000 万美元的 A 轮,三个前苹果研究员,一个尚未发布任何产品的"全双工视听基础模型",两份押注情感智能赛道的投资判断——Nuance Labs 的故事浓缩了当下 AI 创投的经典张力:最前沿的技术判断与最早期的不确定性并存。语音 AI 用十余年时间走完了从技术到产业的验证之路,面对面的 AI 能否用更短的时间完成从技术 demo 到新一代交互入口的跨越,2026 年的研究预览将给出第一个公开答案。在此之前,理性看待这笔交易的方式是:它买下的是一个赛道的定义权,而不是一个已被验证的商业模式。