全球AI大模型聚合平台OpenRouter的周度统计显示,近两个月全球大模型周调用量持续跳升:8月第三周为93.4万亿Token,9月第二周升至127万亿Token(单周环比增长10.4%),10月5日至10月11日当周达172万亿Token,10月19日至10月25日当周进一步升至188万亿Token(环比增长14.63%);最新完整周内,中国大模型周调用量93.54万亿Token、约为美国的4.2倍,且连续二十六周超过美国、全球周调用量前五均为中国AI大模型。与此同时,新加坡国家级AI项目将开源基座从Meta Llama切换为阿里通义千问,华为云把中国模型货架整体搬进亚太机房,金山办公以唯一S级评级领跑AI办公出海,Chance AI则选择“为海外而生”。本文回答两个战略问题:调用量领先的本质是什么;应用出海为何分化为两条路线。
一、从93.4万亿到188万亿:近两个月周调用量的全球坐标
截至10月28日发稿,最新完整周度数据更新至10月25日,10月26日起当周数据尚未完整发布。把观察窗口拉长到近两个月,周度数据呈现一条陡峭的上行曲线:8月第三周,全球AI大模型总调用量达到93.4万亿Token,约为2025年末调用量的16.8倍,当周中国大模型周调用量已连续17周超过美国、稳居全球首位;9月第二周,全球总调用量升至127万亿Token、单周环比增长10.4%,中国模型调用量连续20周超过美国,在平台调用量前十中占八席。
进入10月,增长进一步加速。10月5日至10月11日当周,全球总调用量达172万亿Token;10月19日至10月25日当周,全球总调用量达188万亿Token、环比增长14.63%。从8月第三周的93.4万亿到10月下旬的188万亿,两个多月间全球周调用量翻了一倍(据此测算)。
中国模型的周度曲线同样清晰。9月28日至10月4日当周,中国AI大模型周调用量为57.46万亿Token,同期美国为16.2万亿Token,前者达到后者的3.5倍;10月5日至10月11日当周,中国大模型周调用量升至86.74万亿Token、达到同期美国的4.5倍,环比增长逾五成(据此测算),连续24周超过美国,全球周调用量排名前五均为中国民企AI大模型;10月19日至10月25日当周,中国大模型周调用量达93.54万亿Token、环比增长18.14%,同期美国为22.47万亿Token、环比增长29.44%,中国约为美国的4.2倍(据此测算),连续二十六周超过美国、稳居全球首位,全球调用量排名前五均为中国AI大模型。值得注意的是,美国单周环比增速(29.44%)高于中国(18.14%),中美周调用量的倍数较前一统计周(4.5倍)有所收窄(据此测算约4.2倍)——领先优势的斜率变化,是后续观察的关键变量。
模型层面的周度更替同样活跃。10月5日至10月11日当周,DeepSeek V4.1 Flash单周消耗41万亿Token,智谱GLM 5.3 Flash为12.2万亿,小米MiMo为11.5万亿;至10月19日至10月25日当周,10月17日上线的DeepSeek V4.1-Flash-1017以33.6万亿Token、环比增长801%登顶全球第一,9月10日上线的旧版V4.1 Flash周调用量18万亿Token、环比下滑45%,反映开发者群体快速向新版迁移。需要说明统计口径:OpenRouter是第三方聚合平台,OpenAI与Anthropic的调用主要经由自有渠道完成、不计入该统计,不同平台与时段的Token数字亦不宜混用。因此,它度量的并非厂商收入,而是全球开发者在可随时替换的模型之间“用脚投票”的结果——连续二十六周的领先,反映的是开放市场上开发者选择的结构性变化。
这一变化提出两个战略问题。其一,调用量领先的本质是什么——是技术追赶完成后的自然外溢,还是价格竞争主导的份额扩张?其二,当模型层确立全球“默认选择”地位之后,应用层为何没有形成单一路径,而是分化出“中国经验平移”与“海外原生”两条截然不同的路线?厘清这两个问题,需要先把各层的事实底盘摆全。
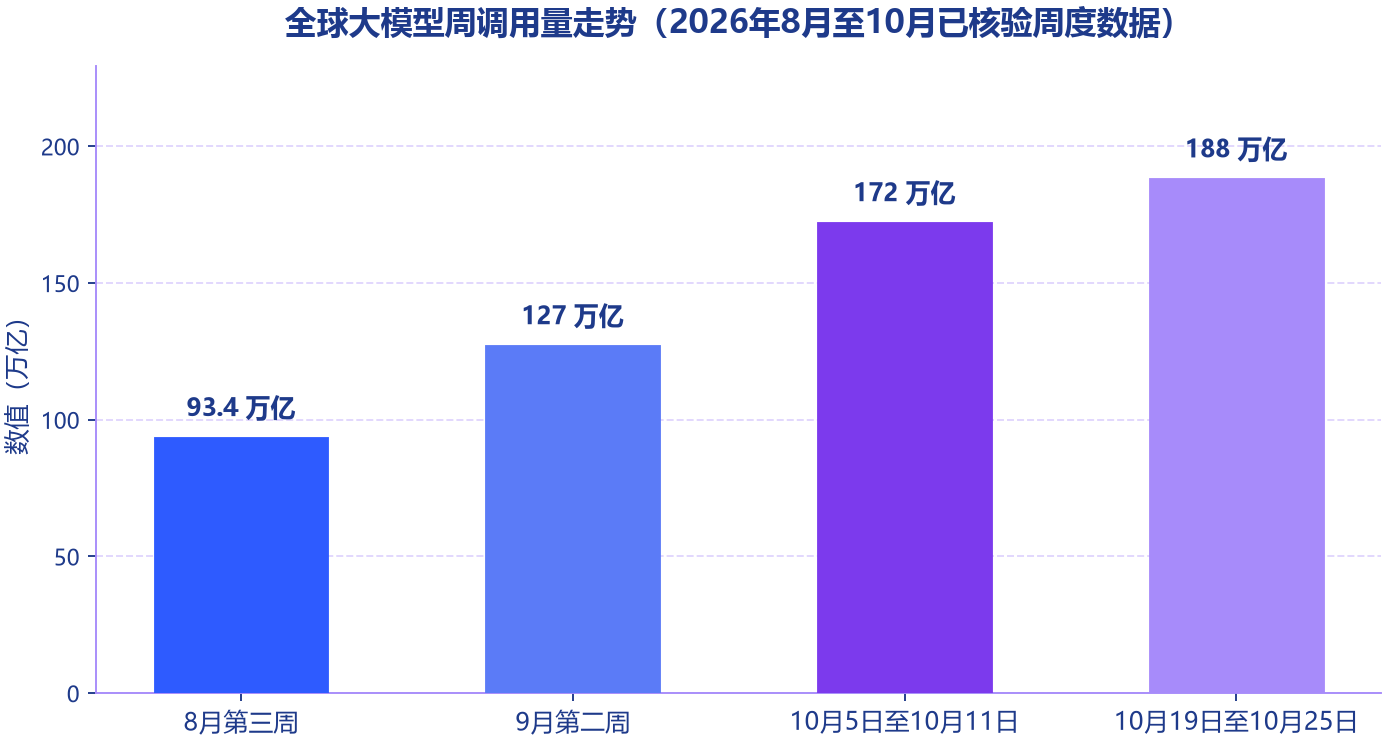
图1 全球大模型周调用量走势(2026年8月至10月已核验周度数据)
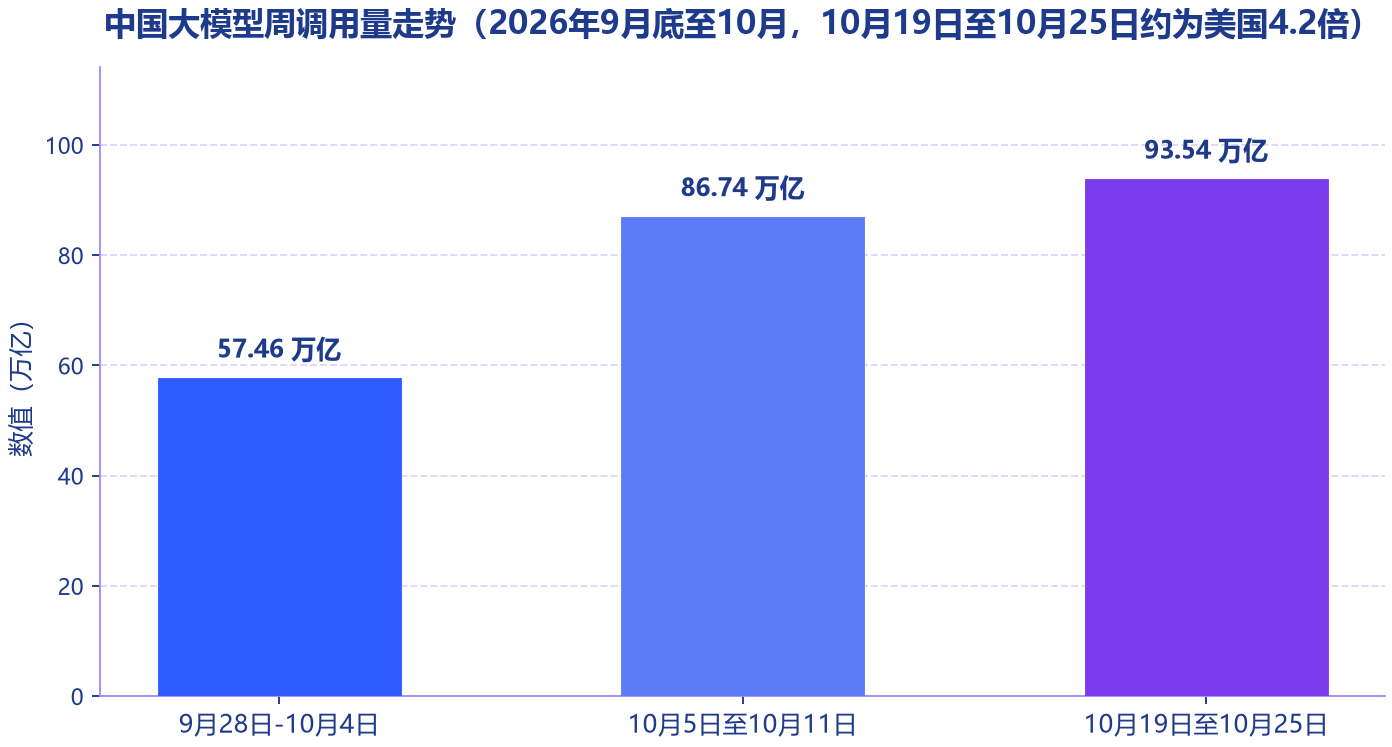
图2 中国大模型周调用量走势(2026年9月底至10月,10月19日至10月25日约为美国4.2倍)
二、模型层事实底盘:性价比、开源与调用量霸榜
调用量领先的第一重支撑是价格。截至10月17日:中国月之暗面的Kimi K3每百万Token输入价格为3美元、输出价格为15美元,平均每项任务成本为2美元;而美国Anthropic的Claude Fable 5.1输入价格为10美元、输出价格为50美元,平均每项任务成本达7.63美元。以此计算,Claude Fable 5.1的输入、输出价格均为Kimi K3的3.3倍,单任务成本达3.8倍;其平均每项成本更是DeepSeek V4.1 Flash的28倍。OpenRouter数据与分析负责人贾斯汀·萨默维尔对CNBC的表述更为直接:中国开源模型的价格普遍比美国头部模型低六到九成。
第二重支撑是性能收敛。据美国斯坦福大学《2026年AI指数报告》:自2025年初以来,中美两国模型已多次交替登顶性能榜单,一年来差距虽有波动但始终保持个位数;截至2026年3月,美国顶尖模型和中国顶尖模型之间的差距仅有2.7%。'性能足够好'叠加显著价差,构成了开发者迁移的完整理由。英特尔首席执行官陈立武即公开表示,DeepSeek、Kimi和GLM等中国前沿AI模型不仅使用成本较低,而且性能已经'足够好',能满足实际应用需求,市场采用速度也'非常快';英伟达首席执行官黄仁勋此前亦指出,中国开放的AI大模型降低了AI使用门槛,'开放AI是推动全球进步的催化剂'。
第三重支撑是采用面的扩散。据英国《金融时报》报道,为降低技术成本,美国外卖巨头DoorDash、全球旅行房屋租赁平台爱彼迎和德国科技巨头西门子等大型企业纷纷转向中国AI模型;另据美国投资机构数据,目前多达80%的美国AI初创公司在融资路演时会使用中国的开源模型。在肯尼亚、尼日利亚等非洲国家,开发者正把中国开源模型作为本地创新的'工具箱',用于优化商业服务流程、开发教育工具和搭建本地聊天机器人。
从单模型看,周度竞争呈现“新版快速替代旧版”的高频迭代特征:10月5日至10月11日当周,DeepSeek V4.1 Flash一家消耗41万亿Token,智谱GLM 5.3 Flash为12.2万亿,小米MiMo为11.5万亿;至10月19日至10月25日当周,10月17日上线的DeepSeek V4.1-Flash-1017以33.6万亿Token登顶全球第一(环比增长801%),9月10日上线的旧版V4.1 Flash降至18万亿Token(环比下滑45%),MiniMax M3.1 Flash(免费版)13.7万亿、智谱GLM 5.3 Flash为13.2万亿、腾讯Hy4 preview为8.97万亿紧随其后。价格策略亦出现值得注意的变化:月之暗面7月发布的Kimi K3定价与Anthropic Sonnet 5完全一致——中国模型首次未以折扣价进入市场,而是参照美国头部模型的定价体系收费。
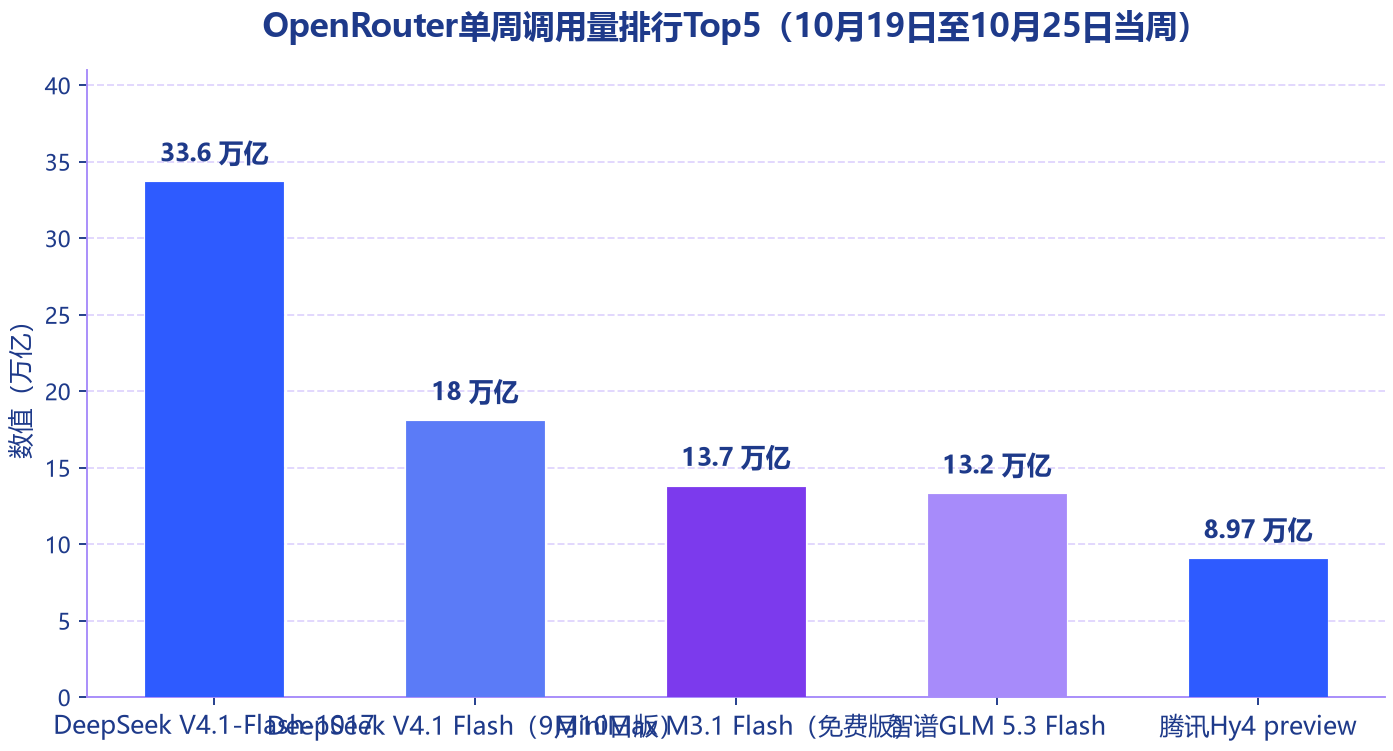
图3 OpenRouter单周调用量排行Top5(10月19日至10月25日当周)
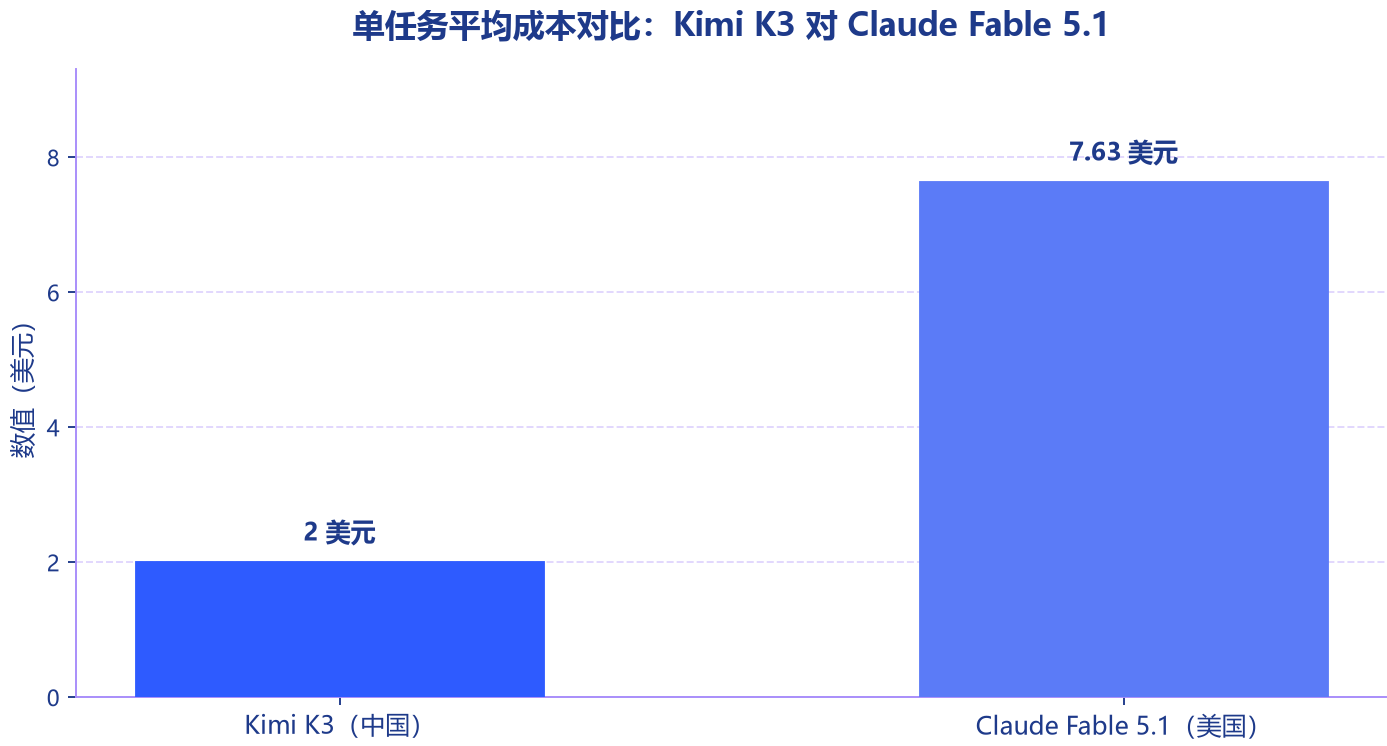
图4 单任务平均成本对比:Kimi K3 对 Claude Fable 5.1
三、模型层战略解读:价格洼地还是生态卡位
将调用量数据放回竞争格局中观察,其战略含义高于单纯的份额数字。若领先仅由低价驱动,其护城河将随对手降价而消失;但三个经核验的事实指向另一种结构。第一,价格差距与性能收敛同时存在——2.7%的性能差距使价格因素从'补偿项'变为'放大器':在质量可用性达标的前提下,价格每低一分,迁移意愿便呈非线性上升。第二,定价权出现松动信号:Kimi K3按与美国旗舰模型同价进入市场,当周登顶Arena前端代码榜(1679分)、上线不到一天即因请求满载暂停新用户订阅,其海外付费用户和API收入在K3发布后同比增长约400%、公司ARR于8月突破10亿美元。这说明中国模型已具备在部分细分场景'不以折扣换量'的能力。
第三,也是最关键的信号,来自开源基座主权的更替。新加坡国家人工智能计划(AISG,与新加坡资讯通信媒体发展局IMDA联合主导SEA-LION项目)发布Qwen-Sea-LION-v4东南亚多语言大模型,将基座从Meta Llama系列切换为阿里通义千问Qwen3-32B,并在东南亚语言综合评估基准Sea-Helm的开源模型榜单(参数量2000亿以下)登顶。切换原因具有典型性:Llama在印尼语、泰语、马来语等低资源语言上表现不佳;而Qwen3预训练覆盖119种语言/方言、含36万亿Token,其字节对编码(BPE)分词方案可无空格切分泰语、缅甸语字符。AISG为此注入1000亿东南亚语言Token(内容浓度13%,为Llama2的26倍),新模型在印尼语、越南语、泰语、马来语任务上平均领先原Llama基线8.4%。该模型已在Hugging Face与AISG官网免费开放下载,并被纳入2023年启动的7000万新元国家级多模态计划,预计2026年在教育、医疗、金融场景规模部署。
国家级项目更换底座的意义在于:开源基座市场的竞争焦点已从'通用能力排名'转向'区域语言覆盖与本地化工程能力'。东南亚地区语言多达1200余种,日常交流普遍多语混用,而西方主流大模型预训练数据中80%以上是标准英语、东南亚语言内容占比一度仅0.5%,这一结构性空白正是中国模型以多语言预训练切入的支点。与此同时,Qwen系列累计开源460多个模型、全球下载量突破30亿次、衍生模型超过30万个,已成为全球开发者二次开发的重要默认底座。价格洼地吸引的是当次调用,生态卡位锁定的则是后续开发——这是调用量领先背后更具纵深的战略层。
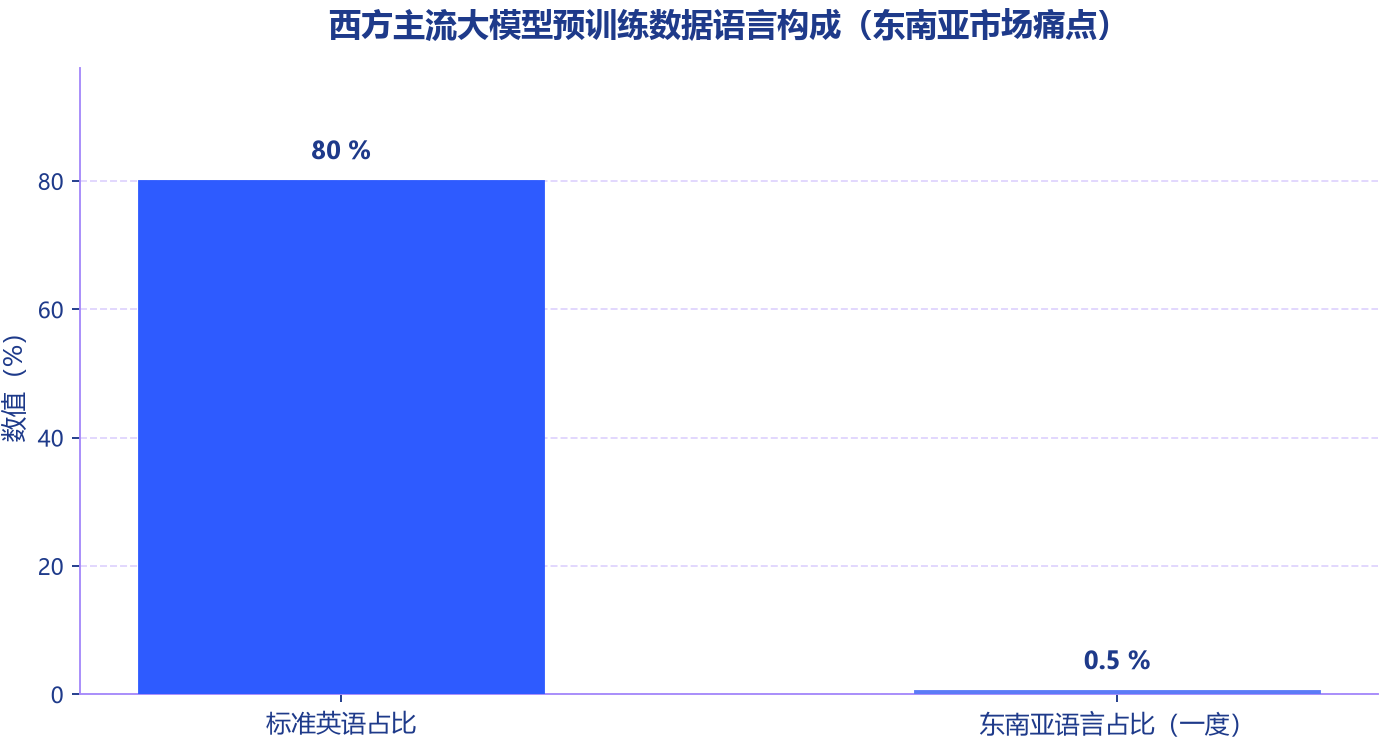
图5 西方主流大模型预训练数据语言构成(东南亚市场痛点)
四、应用层事实底盘:金山办公的'中国经验平移'路线
应用层的出海成绩单中,金山办公是'中国经验平移'路线的代表样本。据其10月27日晚发布的第三季度报告:前三季度累计营业收入50.80亿元、同比增长21.57%;第三季度单季营业收入17.66亿元、同比增长16.11%,经调整后归母净利润5.39亿元、同比增长8.44%。分业务看,WPS个人订阅业务收入10.50亿元、同比增长16.78%;WPS 365收入2.70亿元、同比增长33.83%。截至9月30日,WPS Office全球月度活跃设备数6.78亿、同比增长1.32%,其中PC版月活3.41亿、同比增长7.83%,移动版3.37亿;公司为全球220多个国家和地区的用户提供服务。
AI能力的商业转化在该季报中表述明确:AI功能的持续完善'有效带动用户付费转化率及客单价同步提升'。公司推出AI原生办公产品全新版'灵犀',作为专业个人办公助理实现从需求理解、任务执行到成果交付的完整闭环;组织级方面,AI办公智能体WPS Comate面向机构客户交付'企业大脑'能力。
出海动作呈体系化展开:个人侧,WPS Office国际版上线AI学习助手,帮助海外学生梳理知识、自测掌握程度,适配考前复习、语言及专业学科学习场景;同时上线新版Linux端,首次在Linux端内提供AI办公能力。企业侧,WPS 365国际版已搭建'线上+线下'兼顾的7×24本土化客服体系。第三方评价维度,AI行业榜单与数据服务机构AIGC Rank发布的《中国AI办公出海榜TOP20》中,WPS在海外规模、海外生态、国际版能力等维度全面领先、位居榜首,为唯一获评S级评级的产品。
宏观面上,这一微观样本与总量数据互为印证:工信部《2025年1-8月软件业运行情况》显示,前8个月我国软件业务出口404.4亿美元、同比增长6.4%,软件业务收入96409亿元、同比增长12.6%。(注意:该出口增速为2025年1-8月口径数据。)
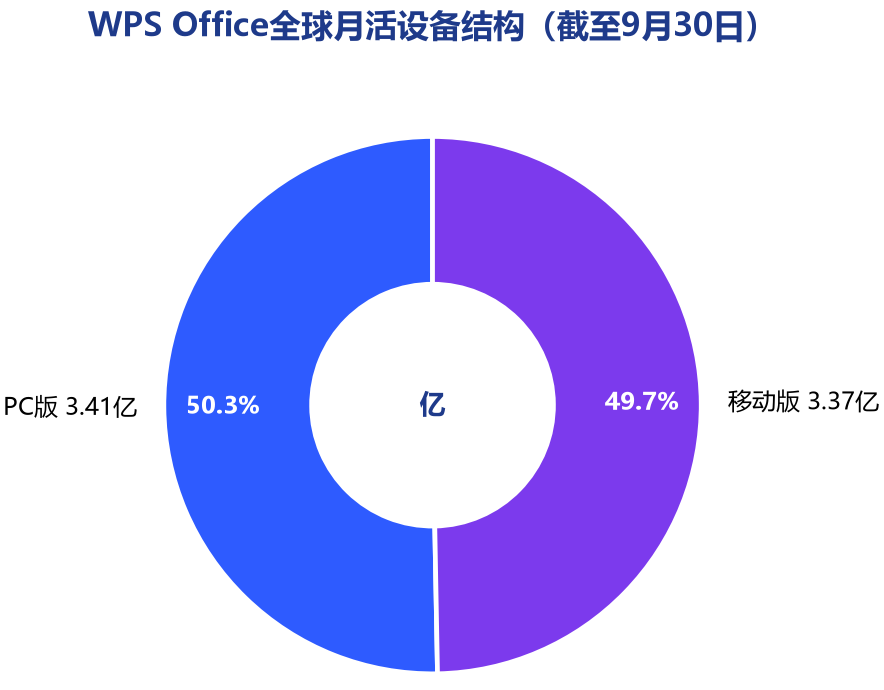
图6 WPS Office全球月活设备结构(截至9月30日)
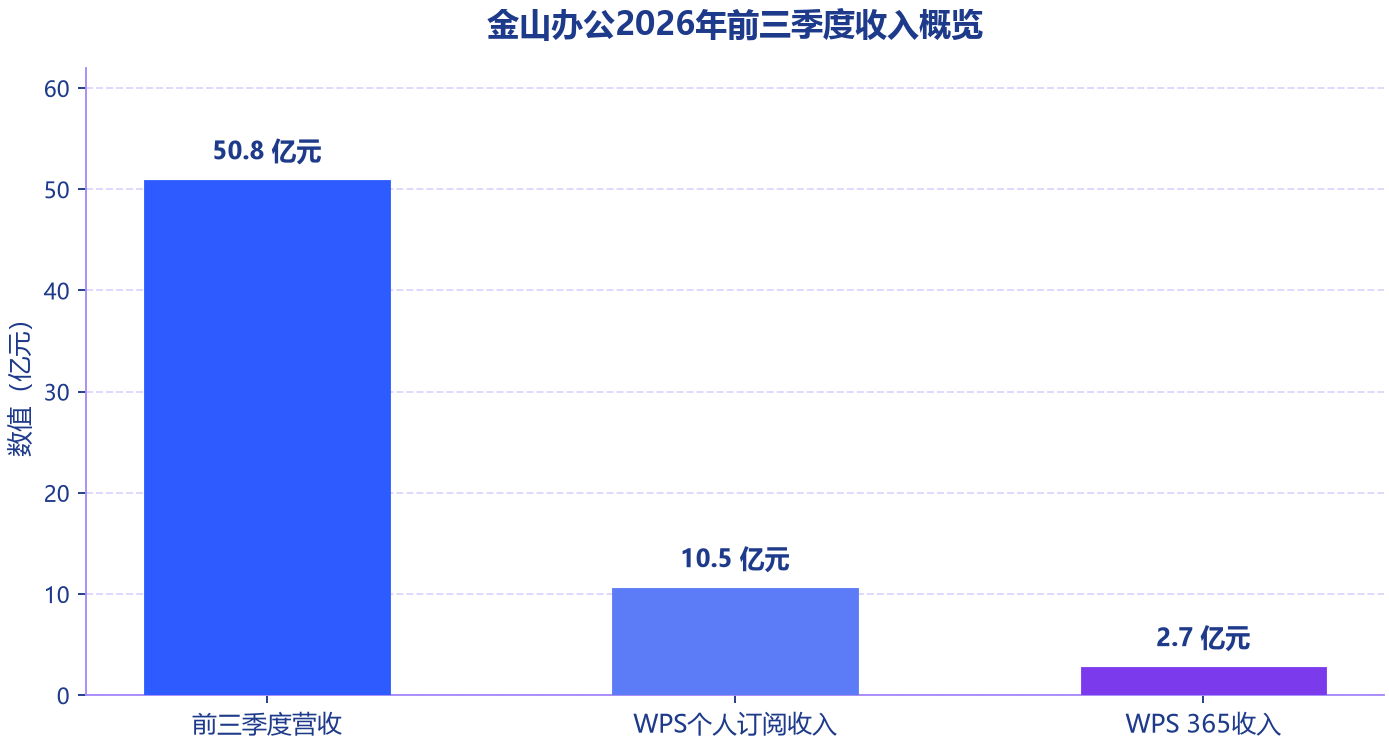
图7 金山办公2026年前三季度收入概览
五、应用层战略解读:Chance AI与Gauth的'海外原生'路线
与金山办公'把中国验证过的产品能力平移到海外'不同,另一类应用选择反向路径:出生即面向海外市场。最典型的是上海团队打造的视觉智能体应用Chance AI——没有搜索框、以相机为唯一入口(camera-first),'先海外、后国内',目前主要面向北美等市场18岁至25岁的年轻用户。
10月的WTCC 2026上,Chance AI发布Visual Skills Platform(视觉技能创作平台):用户以自然语言说明四件事——看什么、在什么场景使用、按什么标准判断、看懂之后做什么——再用真实图片反复测试调整,即可创建一个可复用、可分享的Visual Skill,其他用户可直接在App相机中调用,全程无须编写提示词。其受控研究显示,引入三层个人视觉记忆后,工具查询相关性提升11.2%、端到端任务效用提升9.7%。在此之前的WAIC 2026(今年7月),其新一代视觉推理模型Chance Vision 1.5曾以86.9%的综合准确率登顶MMMU-Pro官方公开榜单全球第一;产品已服务全球约30万用户,积累超过300万张经授权和脱敏处理、可用于模型增强的有效视觉数据。
教育赛道呈现类似逻辑。行业研报口径显示:2024年起,以作业帮旗下Question.AI和字节跳动旗下Gauth为代表的中国AI教育App在海外市场表现亮眼,开启教育出海1.0阶段;2026年AI黑板出海爆火,中国教育出海进入'全球化2.0'阶段,核心竞争力从单一产品输出升级为AI学习能力、教育理念、教学方法论和教育生态的综合输出。
两条路线的成本结构与风险敞口差异清晰可辨。'经验平移'路线以既有的规模化产品与国内验证场景为起点,边际成本低、收入曲线平稳,金山办公三季报即为佐证;其约束在于国际版功能与本土化服务体系的持续投入,以及与本土对手的正面竞争。'海外原生'路线则从目标市场的真实场景反向定义产品——Chance AI放弃搜索框、以相机为入口即是典型决策——其优势在于组织形态与产品逻辑天然贴合当地用户,且在小众爱好群体中形成自发的技能生态;其代价是前期投入高、增长曲线陡峭、对单一区域市场的依赖度更高。何种品类适合何种路径,取决于产品对本地场景规则的依赖深度:办公工具的通用性强,平移即可成立;视觉理解与教育体验高度依赖本地语境,原生反而更有效率。
六、三层协同的传导逻辑:从输出产品到输出生产工具
模型层的'默认选择'效应,正沿产业链向上游和下游同时传导,基础设施层是其中最直接的受益环节。4月21日,华为云在雅加达举办主题为'Agentic AI Practice'的AI Boost Day,宣布MaaS(模型即服务)在亚太正式上线:首发托管GLM、DeepSeek、Qwen三系六款模型(含最新GLM-5,官方称其在编码与智能体能力上达到SOTA),面向智能问答与AI编码两大场景,提供一键接入、开箱即用的模型托管与按量计费服务。此前4月10日,华为云已宣布MaaS面向新加坡、泰国、印尼、巴西、墨西哥、沙特、阿联酋、南非、土耳其9国正式发布。基础设施方面,华为云在亚太的新加坡、泰国、中国香港、印尼、菲律宾5个Region共18个可用区实现50毫秒接入时延,并与伙伴在马来西亚共建本地云;编码智能体CodeArts与智能体平台AgentArts计划2026年下半年在中国大陆以外上线。客户案例显示,讯飞依托华为云AI算力服务在2周内完成大模型训练资源部署,并保持60天稳定运行。
垂直玩家的区域深耕与云平台的货架输出形成互补。9月17日,科大讯飞在第22届中国—东盟博览会(南宁)发布'星火东盟多语言大模型底座':基于纯国产化软硬件打造,覆盖东盟十国十种重点语言(马来语、印尼语、泰语、越南语、菲律宾语、缅甸语、高棉语、老挝语、泰米尔语、爪哇语),并与老挝科技与通讯部、马来西亚好享广播电视电影集团、泰国北榄府教育局等东盟伙伴签约;东博会开幕式现场配备七种语言实时字幕,议程结束后由AI一键生成会议纪要与新闻稿。经营面上,2026年4月Gitex Asia 2026期间披露:讯飞2024年设立的新加坡办公室硬件销量已突破1万台、产生约2亿元人民币营收,区域业务去年增速超过200%;公司表示中东仍是关键支柱,但投资正加速转向东南亚,预计未来一年新加坡团队规模与整体业务规模均增长超过50%。
三层协同的传导链条由此完整:模型层以性价比与开源确立全球开放市场的'默认选择'地位,并借助区域语言工程能力(如Qwen对东南亚119种语言的覆盖)拿下国家级基座项目;基础设施层随后把'中国模型货架'整体外移——华为云托管GLM、DeepSeek、Qwen三系模型进入亚太机房,讯飞在东盟输出多语言基座与行业方案,客户得以在海外复用国内技术栈;应用层则承接模型能力,分化出经验平移与海外原生两条路线。值得强调的是,这一进程输出的已不只是终端产品,而是'模型+算力+开发平台+应用方法论'的生产工具本身。
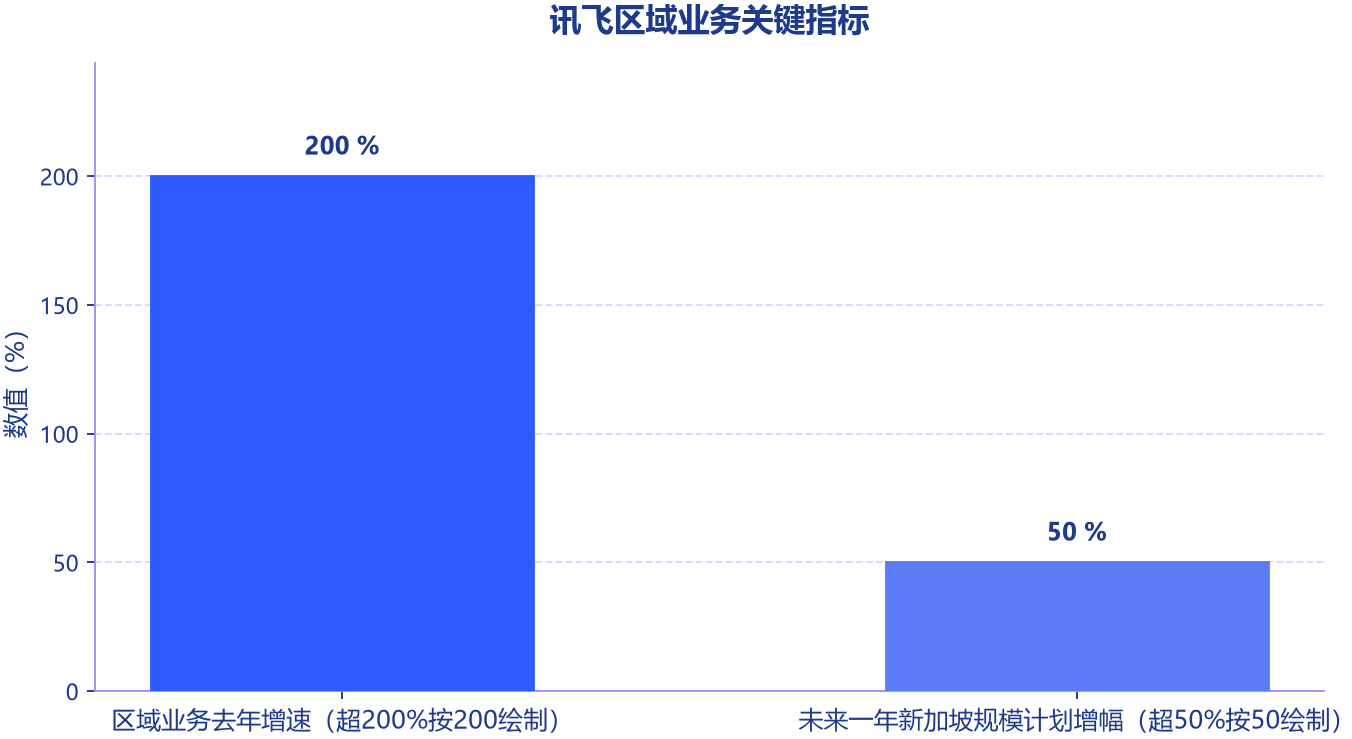
图8 讯飞区域业务关键指标
七、结语:从调用量第一到生态与定价权的距离
回到开篇的两个战略问题。其一,调用量领先的本质,是'性能收敛至可用阈值之内'与'结构性价差'共同作用的结果,并已开始向定价权延伸——Kimi K3对标定价、部分厂商提价后需求未流失等信号表明,中国模型正从'以价换量'走向'以质定价'的早期阶段;但OpenRouter口径不含OpenAI与Anthropic自有渠道调用,对领先幅度应保持克制解读。其二,应用出海的两条路线并非优劣之分,而是对'产品与本地场景规则依赖深度'的两种理性回应:通用性强的办公工具适合经验平移,场景依赖深的视觉智能体与教育产品更适合海外原生。
后续观察可锚定三点:调用量优势在统计口径扩展后的持续性;区域语言基座模式(SEA-LION式换底座)向其他非英语市场的可复制性;以及两条应用路线在商业化验证上的分化结果。调用量不等于收入量,价格战不等于定价权——中国大模型出海的下一个阶段,看点在于把调用量的领先,转化为生态锁定与标准输出的能力。