一、从"模型排名"到"资本排位"
过去两年,对比大模型厂商,大多停留在参数规模、跑分榜单和定价表上。但2026年的全球大模型竞争,已经从"单模型能力排名"进入"模型能力、算力供给、产品入口、企业客户、监管安全和资本效率"的综合竞争阶段。国内券商在2026年秋季策略中进一步指出,全球大模型格局正呈现"中美双极分化、开源逼近闭源"的态势:美国以OpenAI、谷歌、Anthropic为代表的闭源模型继续领跑通用能力,中国以DeepSeek、通义千问为代表的开源模型凭借混合专家(MoE)架构与极致性价比,在中文理解、代码生成等维度实现局部超越。
在这样的格局下,仅比较模型能力已不足以解释厂商行为差异。本文以22家代表性大模型企业清单为骨架,划分为国内大厂、国内初创、海外巨头、海外初创四个象限,并重点引入"上市vs未上市"的资本属性维度。原因在于:资本结构直接决定了厂商的战略函数——上市公司必须向股东交卷,追求营收、利润与市值回报;未上市初创则可以依靠私募融资持续输血,把资源优先投入模型性能与技术标杆的争夺。开源与闭源的分野,本质上也是两种资本结构的分野。
二、22家厂商全景图谱:四象限与"哑铃型"结构
2.1 图谱总览:资本属性的"哑铃型"分布
将22家代表性企业按"地区×资本属性"交叉盘点,可以看到一个清晰的"哑铃型"结构:一端是清一色互联网巨头或老牌AI公司的上市阵营,共9家(国内6家、海外3家);另一端是以明星初创为头部的非上市阵营,共12家;另有1家事业单位属性的非商业机构(上海AI实验室)。
【图表:全球22家代表性大模型企业资本属性分布】
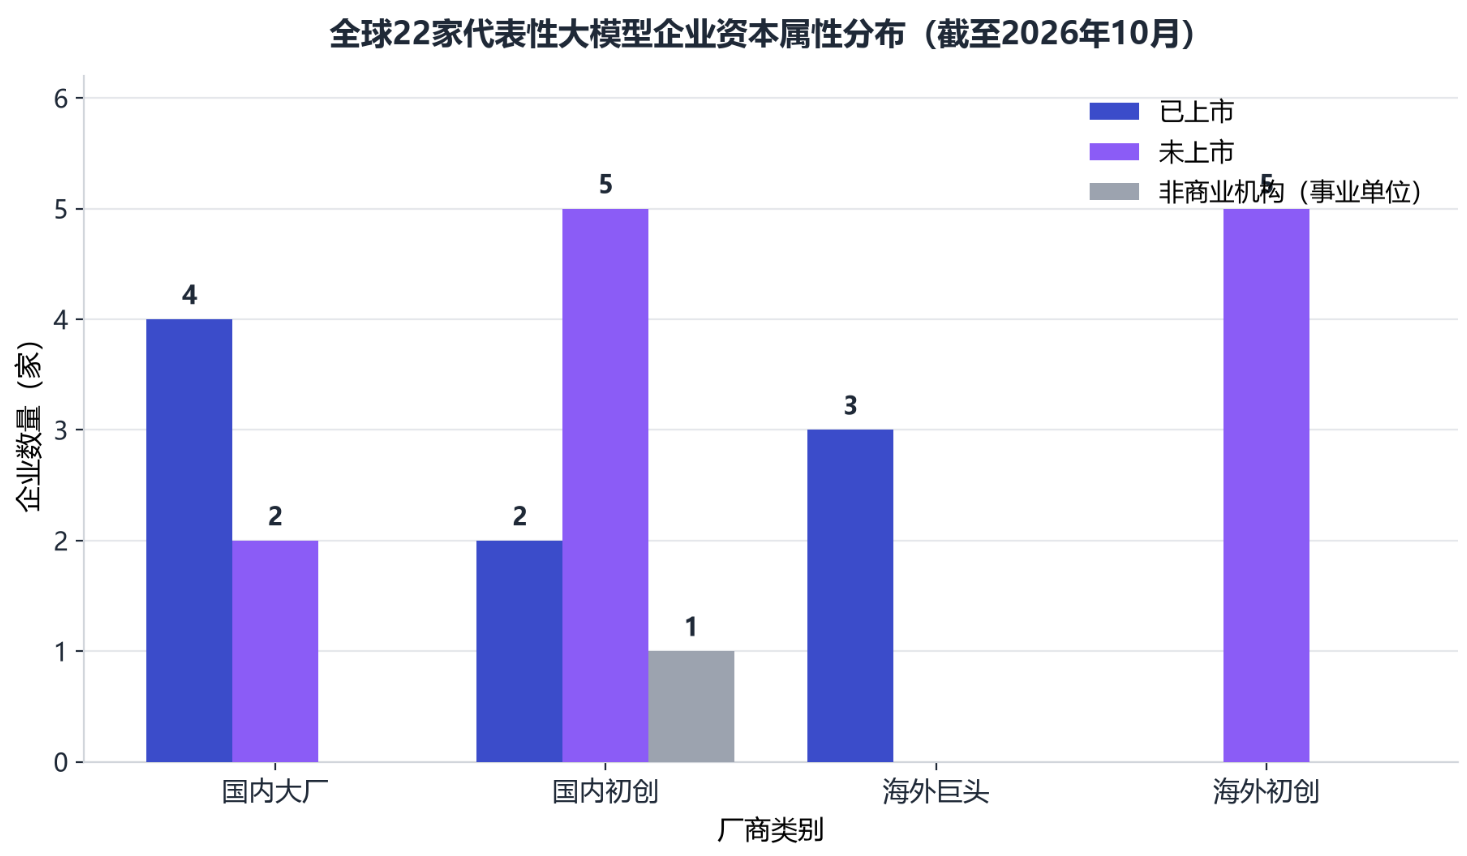
具体分布如下:国内大厂中,百度(文心一言)、阿里巴巴(通义千问)、腾讯(混元大模型)、科大讯飞(星火大模型)4家均已上市,未上市的2家为字节跳动(豆包)与华为(盘古);国内初创中,智谱AI与MiniMax已于2026年初上市,DeepSeek、月之暗面、阶跃星辰处于IPO筹备阶段,百川智能、零一万物仍处融资阶段,另有上海AI实验室为事业单位;海外巨头中,谷歌(Gemini)、Meta(Llama)、亚马逊(Titan)3家上市;海外初创中,OpenAI、Anthropic、xAI、Mistral AI、Hugging Face 5家均未上市。
值得注意的结构性特征有三点。其一,上市阵营全部是巨头或已跑出商业化路径的头部初创,尚无一家海外初创上市——OpenAI、Anthropic仍在递表途中;其二,"上市"状态在2026年初发生标志性变化,智谱与MiniMax成建制叩开二级市场大门,大模型初创第一次拥有了上市样本;其三,开源与闭源的分布与资本属性高度相关——全系列开源的阿里、以开源立身的Meta,背后是巨头生态战略;而闭源阵营中的OpenAI、Anthropic、xAI,无一不是靠巨额私募资本支撑的高投入封闭路线。
2.2 国内大厂:上市巨头扛旗,字节华为体制外突进
国内大厂阵营的显著特征是"上市者众"。百度文心一言背靠搜索与政企场景,阿里通义千问以全系列开源构建生态,腾讯混元深耕图文与内容场景,科大讯飞星火以语音AI底座深耕教育、医疗、政务行业——四家全部是上市公司。而两家未上市玩家中,字节跳动以豆包切入C端交互,据券商2026年中报综述披露,截至2026年6月底豆包大模型日均Token调用量已突破180万亿,较上线初期增长超1500倍;华为则以员工持股的民营企业体制,主攻科学计算、气象、工业、遥感等行业大模型。
2.3 国内初创:从"六小虎"到"双雄",2026年成上市分水岭
2025年12月17日,智谱与MiniMax双双通过港交所聆讯;2026年1月8日,智谱登陆港交所主板,成为全球首家以通用人工智能(AGI)基座大模型为核心业务的上市公司,被称作"全球大模型第一股";1月9日,MiniMax紧随其后挂牌,首日大涨近110%、收报345港元,总市值达1054亿港元,反超智谱的698亿港元。市场曾热议的"大模型六小虎"就此分化:智谱、MiniMax率先上岸并获"AI双雄"之名,DeepSeek、月之暗面、阶跃星辰在IPO筹备中,百川智能、零一万物仍处融资阶段。
2.4 海外巨头与初创:上市三巨头与私募资本巨兽
海外阵营中,谷歌、Meta、亚马逊三家巨头延续"上市+巨头生态"路线:谷歌Gemini原生多模态并深度整合搜索与Workspace生态,Meta以Llama占据全球最主流开源基础模型位置,亚马逊Titan依托AWS主打云原生企业场景。而OpenAI、Anthropic、xAI则代表了私募资本堆出的闭源前沿路线,其估值与融资规模已与上市公司不在一个量级。此外,法国Mistral AI以小参数量、高推理速度成为欧洲开源代表,Hugging Face则以模型仓库与托管平台成为开源生态基础设施。
三、上市与未上市:两种资本结构,两种战略打法
3.1 上市阵营:营收、利润与市值的三重约束
"大模型双雄"的上市成人礼
上市是一面镜子,照出了大模型商业化的真实成色。2026年1月上市时,智谱发行价116.2港元、募资约43.5亿港元,MiniMax发行价165港元、募资约55.4亿港元,两家公开发售分别获得1159倍和1837倍超额认购,IPO估值均在500亿港元附近。随后股价一度狂飙:智谱6月22日盘中触及2980港元、市值一度达1.33万亿港元(13300亿港元),以2025年约7亿元收入计,峰值静态市销率超过1000倍;MiniMax 3月盘中摸至1330港元、市值一度突破4000亿港元。
但狂欢未能持续。到10月上旬,智谱收报711.5港元、市值约3469亿港元,较峰值最大回撤约80%;MiniMax收报207.2港元、市值约730亿港元,较3月高点蒸发约3400亿港元、缩水约80%,其间还经历了7月9日1.53亿股(占总股本约48.9%)首批解禁、当日股价跌近18%的冲击。
【图表:智谱与MiniMax上市以来市值变化】
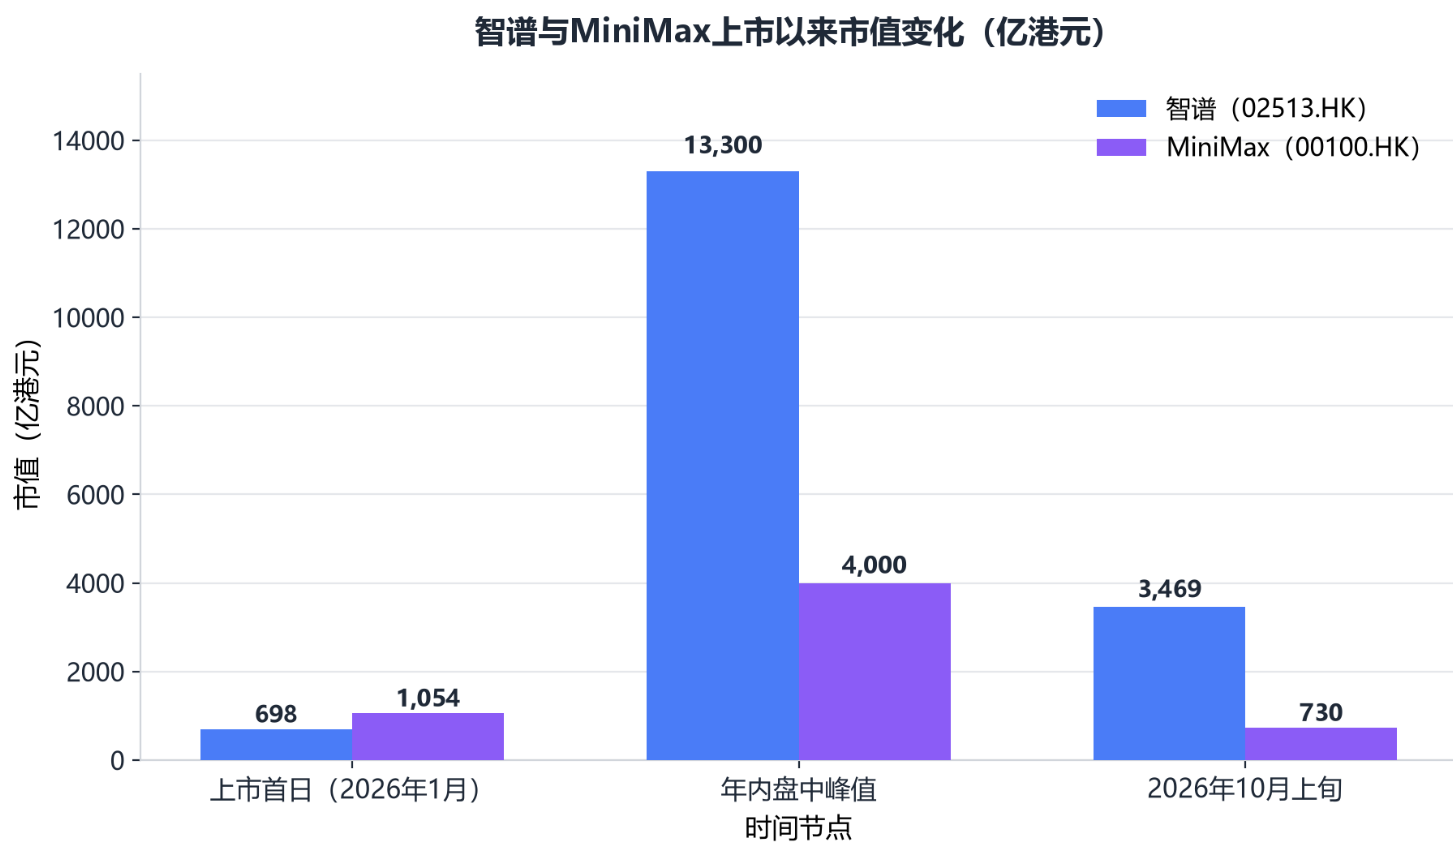
市值回落的根本原因在财务基本面:营收在涨,赚钱能力却没跟上。根据两家公司2026年中报,上半年收入均已超过去年全年,但剔除上市带来的优先股公允价值重估等账面因素后,经调整净亏损都在扩大——新一代模型居高不下的训练成本,以及随用户量与API调用量攀升而不断推高的算力、推理成本,都在反向吞噬利润。
商业化路径的分化也直接写进了股价。智谱2025年实现收入7.24亿元、同比增长131.9%,MaaS平台ARR约17亿元、12个月提升60倍;MiniMax 2025年总收入7903.8万美元(约合5.46亿元)、同比增长158.9%,超70%收入来自国际市场、全球用户约3亿。上市后的打法随即分岔:智谱自2026年2月发布GLM-5起连续上调API价格,3月、4月、9月三度提价,至8月末MaaS平台词元调用量较年初增长超40倍、API定价同比提高101%、开放平台及API业务毛利率升至24.6%——"涨价不丢客户"被视为定价权最硬的证据;MiniMax旗舰模型M3则在6月1日发布约一周后宣布永久降价50%,摩根大通随即将其评级从增持下调至中性。
【图表:2025年智谱与MiniMax营业收入与研发费用对比】
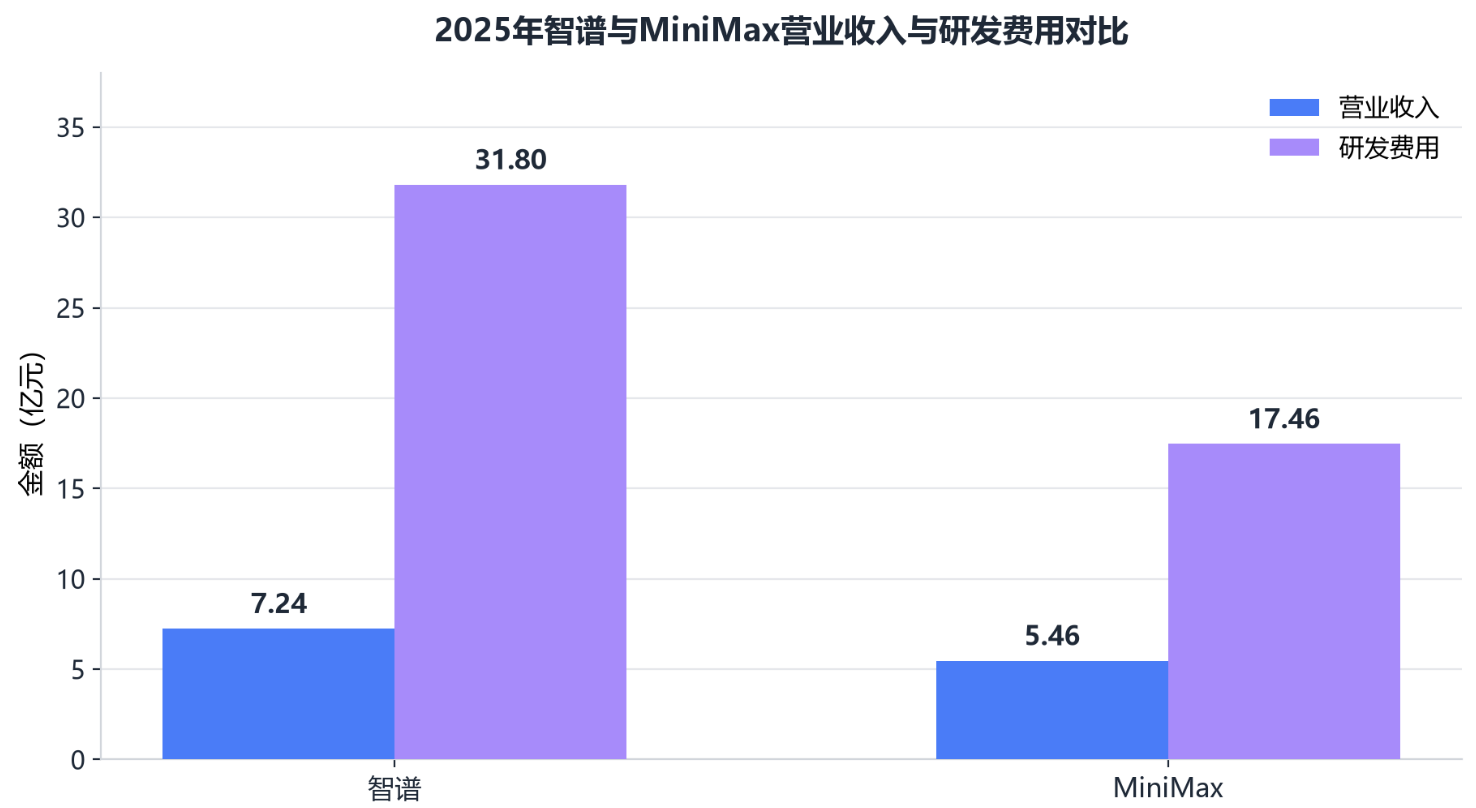
收入高增长与高研发投入的剪刀差,是两家公司亏损的直接来源。2025年智谱、MiniMax研发费用分别为31.80亿元和17.46亿元,同比增长45%和32%,均远超当期收入。按港股5月13日市值折算,智谱市销率约650倍、MiniMax约405倍,显著高于OpenAI的约37倍——上市并未让它们摆脱"以估值换投入"的循环,反而把烧钱的透明度摊在了全体股东面前。
上市之后,融资并未停止,只是换了形式。智谱7月完成31.41亿港元股权配售、叠加可转债合计获约50亿美元融资,7月、9月两轮融资合计达700亿港元,刷新中国人工智能企业累计融资规模纪录;MiniMax同步完成配售及零息可转债合计约160亿港元,约80%用于AI基础设施及研发。更进一步,智谱2月即聘请国泰海通、中金公司推进上交所科创板上市辅导,MiniMax也于5月29日与中信证券签署辅导协议、启动"A+H"双平台布局[8]——上市不是终点,而是更大规模融资的起点。
科大讯飞:以经营现金流养AI的上市样本
与尚在亏损的初创不同,科大讯飞展示了上市公司"以主业现金流反哺大模型投入"的另一种打法。2025年其营业收入达271.05亿元,归母净利润8.39亿元(此前业绩预告区间为7.85亿元至9.5亿元、同比增长40%至70%),研发投入53.64亿元、占营收比重19.79%;2025年销售回款总额超274亿元、较上年同期增长45亿元,经营活动现金流量净额32.08亿元创历史新高。大模型直接贡献也在放量:2025年星火大模型相关项目中标金额达23.16亿元,中标数量与金额居全行业双第一、超过第二名至第六名之和。2026年上半年,其研发投入进一步增至30.07亿元、同比增长25.73%、占营收比重超25%,API及MaaS平台服务收入同比增长约70%,6月单月Token调用量已达2025年全年总量的2倍;2026年4月,公司还完成约40亿元定向增发,募资投向星火教育大模型与算力平台扩建。
营收、回款、利润、再融资——科大讯飞的每一步投入都对应着明确的资金来源与股东回报约束,这正是上市公司资本纪律的典型体现:AI投入必须与主业现金流、盈利改善挂钩,而非单纯依赖外部输血。
上市巨头:资本开支竞赛与"减掉AI看利润"
巨头同样面临投入与回报的平衡。2025年第二季度,微软、亚马逊、Meta、谷歌四大海外云巨头合计资本开支同比提升69%至874亿美元,全年预计同比增长50%至3338亿美元。国内方面,阿里巴巴宣布未来3年投入超3800亿元建设云和AI硬件基础设施,超过其过去十年的投入总和;腾讯2025年全年资本开支792亿元(约占营收一成)、2026年一季度单季即达319亿元;百度2025年资本开支120.73亿元、同比增长48.4%,2026年一季度再增104%至59.16亿元,同期百度AI云收入88亿元、同比增长79%。2025年前三季度,阿里、腾讯、百度合计资本开支1637亿元、同比增长92%。
巨头财报中最耐人寻味的细节,是腾讯2026年一季度首次主动披露"剔除新AI产品(混元、元宝、CodeBuddy、WorkBuddy等)收入、成本及开支"后的经营盈利:剔除口径为844亿元、同比增长17%,包含口径为756亿元、同比增长9%——市场将其解读为"看利润的时候,先把AI减掉"。与此同时,截至2026年8月21日,百度、腾讯、阿里股价较2025年底分别下跌29%、24%、14%,市场对"投资侵蚀利润"的担忧直接体现在市值上。
与之对照,未上市的字节跳动2025年资本开支约1500亿元、其中900亿元明确投向AI算力,2026年计划进一步上调至2000亿元以上——没有披露义务和季度盈利考核的字节,可以把赌注下得更重。
3.2 未上市阵营:融资输血、堆性能、抢标杆
国内未上市初创:一级市场的天价弹药
未上市初创的战略函数完全不同:没有公开市场的季度盈利考核,融资能力、模型标杆与估值叙事成为核心资产。DeepSeek在2026年6月完成首轮外部融资超70亿美元(约合超500亿元人民币),创下国内AI单轮融资纪录,投后估值近3500亿元,国家人工智能产业投资基金、腾讯及宁德时代等为主要出资方;10月又被传接近锁定至少800亿元、最高近1000亿元的新一轮融资,若按投前约5000亿元落地,将站上国产大模型公司私募估值的最高位。耐人寻味的是,DeepSeek年收入估算仅约1.3亿元至5亿元区间,市销率高达1000至3800倍,年度亏损却接近零——背后是幻方量化的算力补贴,这让它成为"一家不想赚钱的公司"的极端样本。月之暗面Series F轮超募至35亿美元、投后估值350亿美元,10月完成IPO前最后一轮私募、估值达500亿美元,其发布的Kimi K3为全球首个3万亿级开源大模型。阶跃星辰被曝将完成近25亿美元融资并拆除红筹架构、全力冲刺港股IPO,零一万物也在推进Pre-IPO融资、计划2027年登陆港交所。
海外未上市双雄:万亿美元估值与巨额亏损并行
OpenAI的收入曲线堪称惊人:年化收入从2023年的20亿美元增至2024年的60亿美元、2025年的200亿美元,2026年2月约250亿美元,9月底约500亿美元,预计2026年底将达700亿美元。但亏损同样惊人:2025年其总投入超340亿美元、净亏损增加七倍,其中研发投入超190亿美元;2026年一季度烧掉37亿美元、超过当季57亿美元营收的一半,全年运营亏损预测在270亿至330亿美元区间(另有口径预计2026年亏损250亿美元)。为缓解成本压力,OpenAI已于2026年1月在ChatGPT免费版投放广告、3月宣布关停Sora产品,即便如此,其推理成本仍将从2025年的84亿美元攀升至2026年的141亿美元。资本市场上,OpenAI在2026年3月完成估值8520亿美元、总额1220亿美元(其中英伟达的300亿美元主要为算力额度而非现金)的融资,9月底又寻求以约1.4万亿美元投前估值募集至少300亿美元,但奥尔特曼表态潜在IPO最早要推迟到2027年——"先适应安全要求,再承受上市公司的资本市场压力"。
Anthropic的资本故事更为陡峭:估值从2025年初的615亿美元攀升至2026年2月G轮的3800亿美元、5月H轮的9650亿美元,IPO目标直指2万亿美元、此前洽谈的募资目标最高达1000亿美元;截至7月底,其年化营收运行率(ARR)已突破650亿美元,2026年二季度营收超115亿美元。但招股书细节显示,其当年经营亏损超过80亿美元、算力与基础设施支出达73.3亿美元,预计2029年前无正向自由现金流。
战略分野:为什么上市与未上市"天然不一样"
两组对比勾勒出战略分野:已上市的智谱、MiniMax在上市后一个提价、一个降价,围绕"收入结构与定价权"做文章;未上市的DeepSeek、月之暗面则以Kimi K3(3万亿参数)、DeepSeek V3(约557万美元训练成本)等模型标杆抢占技术话语权。海外同样如此:未上市的Anthropic以650亿美元ARR狂飙突进,未上市的OpenAI尚在用广告与产品收缩换取上市前的成本曲线改善。正如券商所总结的,国产模型顺利融资"为后续模型训练迭代以及推理算力扩张储备了充足弹药"——融资即弹药,这是未上市阵营的核心逻辑;而对上市阵营而言,弹药是要还的,二级市场已经改按收入结构定价。
3.3 一级市场与二级市场:两个价格,定价权换手
2026年10月的同一周里,港股MiniMax单日收跌超13%、智谱跌超7%,恒生科技指数创2024年9月以来新低;同期一级市场却接连传出天价交易:DeepSeek锁定800亿至1000亿元融资、月之暗面以500亿美元估值完成IPO前最后一轮私募。二级市场的答案是抛售,一级市场的答案是加价——分歧表面是看法,背后是定价逻辑的换手:二级市场已经改按收入结构定价,一级市场还在按稀缺性出价;一级价格是协议价,尚未接受公开检验。
历史的镜鉴值得警惕:过去25年美国排名前十的超级IPO,上市一年后的平均回报为-26.8%,无一为正。有分析指出,行业融资缺口恐达8000亿美元,AI开始靠债市"输血"。当更多优质标的被摆上台面,从前大模型企业靠"讲故事"撑起估值的逻辑,只会越来越难讲通。
四、中美格局:开源逼近闭源,性价比改写竞争
从模型阵营看,全球大模型形成清晰的"二元分化":国际头部阵营(OpenAI、Anthropic、谷歌)坚守闭源高端路线、专注模型能力天花板;中国科技企业则集体押注开源与性价比赛道。综合来看,OpenAI、Anthropic、谷歌、xAI代表前沿闭源路线,Meta、DeepSeek、通义千问、Kimi、MiniMax、文心、混元、豆包等代表开源、开放或高性价比路线。
开源生态的天平正在快速倾斜。Hugging Face统计显示,阿里通义千问系列过去半年在该平台累计下载量超20亿次(约20.45亿次),登顶全球第一,远超谷歌的4.18亿次与Meta的2.27亿次,衍生模型超15.1万个、约为Meta整体的2.6倍。
【图表:2025年Hugging Face平台主要开源模型累计下载量对比】
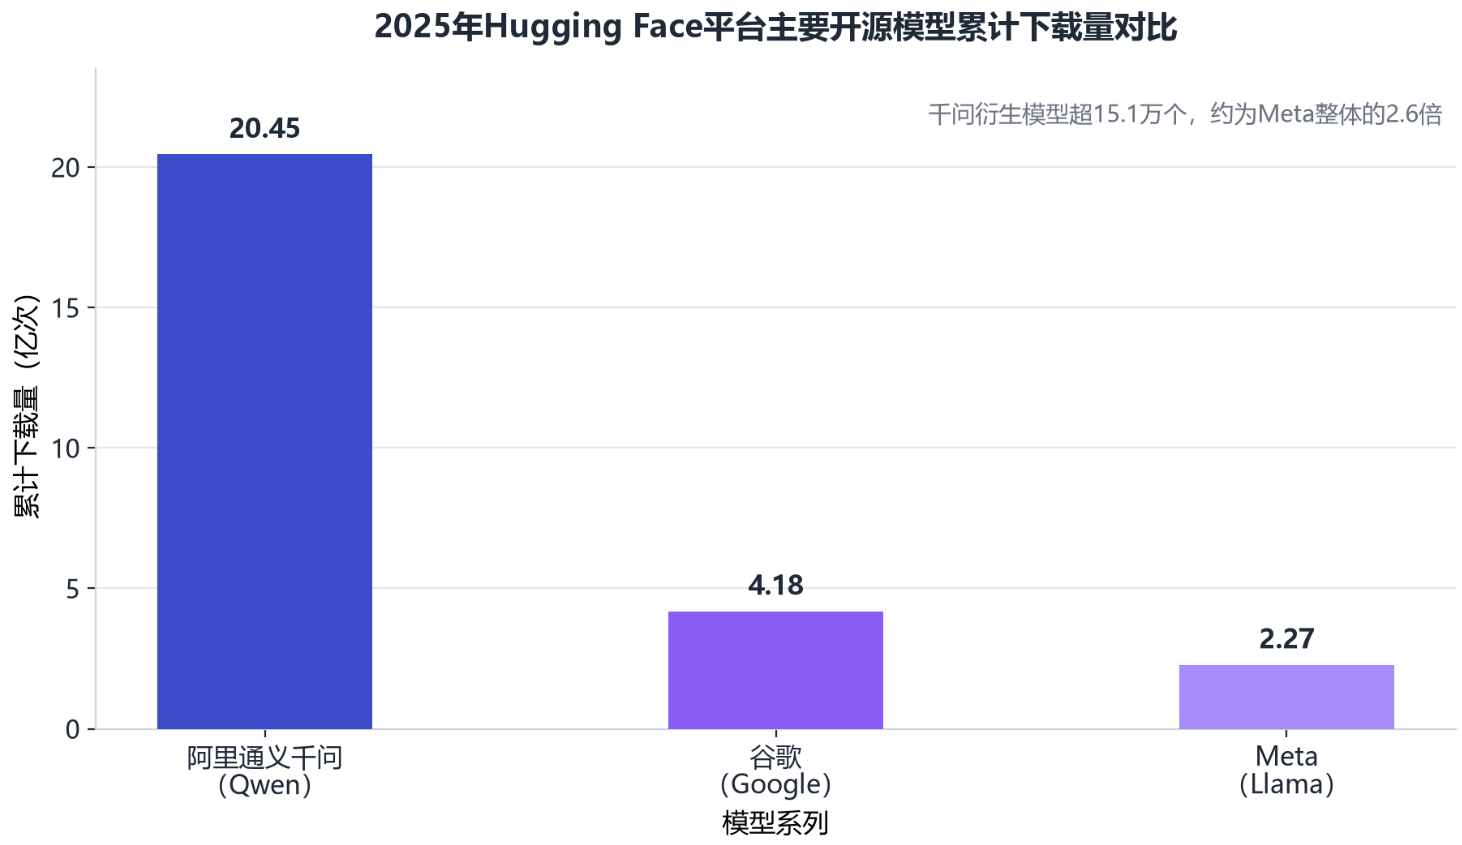
据Hugging Face 2026年春季报告,中国开源模型已占该平台月度及总体下载量的41%,而2024年底这一比例仅为1.2%——一年多时间近40个百分点的跃迁,说明全球开发者正在"用脚投票"。2025年7月,中国7款开源模型(智谱GLM-4.5系列、Kimi K2、阿里Wan-2.2及Qwen3系列等)一度包揽Hugging Face趋势榜前十中的九席,英国《自然》杂志称之为"又一个DeepSeek时刻"。
性价比差距更为直观:按Artificial Analysis"每美元可获得的模型智能"测算,MiniMax M2.5与智谱GLM-5的输入价格仅0.3美元/百万Token,而对标的美系顶尖模型高达5美元,近20倍的成本差异,对每天消耗数十亿Token的开发者而言"不是优惠,而是生死线"。斯坦福《AI Index Report 2025》则显示,顶级闭源模型与最佳开源模型的差距已缩窄至1.7%。
调用量的证据同样指向中国:据OpenRouter统计,2026年8月第三周全球AI大模型总调用量达93.4万亿Token、约为2025年末的16.8倍,其中中国AI大模型周调用量已连续17周超过美国、稳居全球首位。不过,商业价值仍高度集中于闭源侧:2024年7月至2025年7月全球Token使用榜前十中,仅DeepSeek两款开源模型上榜,其余皆为美系闭源模型。美国闭源阵营也已感受到压力——英伟达被曝砸出60亿美元重金打造开放权重模型,试图回应中国开源模型的冲击。
五、2026—2027年IPO大潮:从"讲故事"到"交卷子"
2026年是全球大模型的"上市分水岭"。国内,智谱、MiniMax已实现港股上市并双双启动A股科创板辅导,向"A+H"双平台迈进[8];DeepSeek的新一轮融资被指为2027年IPO铺路,阶跃星辰冲刺港股、零一万物计划2027年登陆港交所,快手旗下可灵也被传最早明年赴港上市、按增资价格测算估值约1228亿元。海外,Anthropic于6月2日率先向美国证券交易委员会秘密递交S-1招股书,OpenAI一周后跟进,两家均剑指万亿美元估值;不过OpenAI已宣布不考虑2026年上市、最早推迟至2027年,Anthropic的上市窗口也可能推迟至11月美国中期选举之后。
这场IPO大潮的本质,是全行业从"讲故事"阶段向"交卷子"阶段的集体切换:上市意味着接受公开市场的收入结构定价,意味着每季度披露训练成本、推理成本与亏损收窄路径。由此可以给出三个判断:其一,资本结构将持续塑造竞争格局——上市阵营以现金流与利润约束换取低成本公开融资,未上市阵营以稀释股权为代价保留战略自由度;其二,估值锚将从"参数与榜单"切换为"收入、毛利与自由现金流",一级市场的天价协议价将陆续接受二级市场检验;其三,开源与闭源的资本模式之争仍将长期并存——开源以生态位换生存权,闭源以独占性换定价权,两条路线的分野与其说是技术选择,不如说是资本结构选择。
六、结论与建议
以22家企业为样本的全景盘点显示:全球大模型产业的资本属性呈"哑铃型"分布,上市9家、未上市12家、事业单位1家;2026年智谱、MiniMax的上市与OpenAI、Anthropic的递表,标志着行业正式迈入资本检验期。
对产业观察者与投资者,本文提出三点建议:第一,跟踪大模型厂商不能只看模型榜单,应将"资本属性—现金流来源—商业化路径"作为分析框架——科大讯飞式的主业反哺、智谱式的提价定价权、MiniMax式的C端全球化、DeepSeek式的产业资本输血,对应完全不同的风险收益结构;第二,警惕一级市场与二级市场的定价剪刀差,未上市独角兽的天价估值在上市后将接受收入结构定价的重估,智谱、MiniMax约80%的市值回撤已是前车之鉴;第三,关注开源生态的资本效率优势——中国开源模型以近20倍的成本优势与41%的下载量份额快速扩张,开源阵营的商业化拐点(毛利转正、自由现金流改善)将是下一阶段的关键信号。
大模型的故事正在从"谁的模型更强"切换为"谁的资本结构更能撑到最后"。上市与否,正在成为理解这场全球竞赛的第一把钥匙。