HBM4带宽达2TB/s但价格高企,HBF与混合介质存算被视为破局方向
9月23日,由深圳市存储器行业协会与北京大学集成电路学院联合主办的第五届GMIF创新峰会在深圳举行。本届峰会以“AI存储,驱动未来”为主题,吸引了近3000名专业观众报名参会。峰会期间,北京大学集成电路学院院长蔡一茂教授发表题为《高带宽存储及存算一体技术》的主题演讲,从学术与产业双重视角,系统梳理HBM技术现状、HBF高带宽闪存进展,以及北大团队在NAND存算一体、RRAM异构存算方向的最新研究成果。
01 推理时代,端侧存储面临三重瓶颈
蔡一茂在演讲开篇分析称,2026年开始,大模型推理应用需求已超过云端训练需求。高通近期发布的2nm芯片已计划将300B参数MoE大模型装载于手机或AI PC,端侧与云边协同的推理硬件支撑,成为集成电路产业面临的重要课题。
借助存储金字塔模型,他指出现有端侧计算系统广泛依赖易失性SRAM和DRAM,面临三重挑战:一是容量不足,端侧DRAM通常仅4~16GB,无法满足13B以上模型存储需求,而KV缓存随上下文窗口增加还会持续膨胀;二是带宽瓶颈,为实现50 tokens/s的生成速度需500GB/s以上带宽,而LPDDR6带宽约115GB/s、Flash带宽约20GB/s,远远不足;三是访存功耗过高,在端侧系统功耗中,DDR占比超70%,已成为系统瓶颈。
蔡一茂表示,大模型参数和KV缓存的增长“永无止境”,除HBM之外,产业界一直在寻找性价比更高的存储技术路径。
02 HBM性能跃升,但价格与功耗成端侧障碍
在HBM部分,蔡一茂系统梳理了HBM4的最新产业格局。HBM4单栈最大容量达64GB,峰值带宽约2TB/s(三星最高达3.3TB/s),接口位宽从HBM3E的1024bit翻倍至2048bit,Base Die从DRAM工艺转向逻辑代工工艺。
“价格是所有新存储技术进入HBM市场的主要攻击点。”蔡一茂表示,HBM的发展速度低于芯片算力增长速度,散热、功耗、封装接口等挑战仍在。
03 HBF破局,首批AI推理设备2027年上市
针对HBM价格高、功耗大的问题,蔡一茂介绍了基于3D NAND的HBF(高带宽闪存)路径。HBF采用与NAND Flash相同的存储介质,保留高密度、低成本、非易失特性。
闪迪与SK海力士于2026年8月联合发布首份HBF标准规范,定义8层和16层NAND芯片堆叠,最高支持512GB容量,数据传输能力覆盖0.4TB/s至3.0TB/s。产业时间线方面,2025年闪迪发布HBF原型,2026年上半年双方合作推动行业标准制定,2026年下半年首批样品交付,2027年首批采用HBF的AI推理设备上市。铠侠与三星也分别宣布研究类似HBF的样品。
蔡一茂对比了HBF与HBM4的关键参数:HBF单栈512GB、峰值带宽1.6TB/s、访问延迟10~50μs、写入寿命10³~10⁴次,定位AI推理与静态权重存储。他指出,HBF目前无法完全取代HBM,但能显著提升系统整体有效带宽。SK海力士提出的H³架构将全部参数及KV缓存存储至HBF,相比单HBM处理批次可提升18.8倍,相同功耗下吞吐效率提升2.69倍。
在HBF近存计算的实际落地验证中,蔡一茂分享了北京大学与燕芯微合作的Mamba模型加速成果。区别于Transformer自注意力模型,Mamba状态转移模型仅产生数十MB的中间数据且大小固定,无需DRAM存储中间数据。该方案基于HBF与SRAM存算异构的加速器架构,相比GPU A100可实现1.4~3.6倍速度提升及12.2~27倍能效提升。
04 NAND存算仍面临三重工程挑战
蔡一茂同时提醒,尽管HBF能显著提升访存带宽,但基于NAND Flash的存算一体仍面临精度、密度与算子匹配三重工程挑战。
计算精度方面,模拟域存算因阈值电压涨落、背景模式依赖等原因导致计算精度下降;存储密度方面,为保证计算精度常采用单比特(SLC)存储,密度从QLC的约15Gb/mm²降至约3.75Gb/mm²,成本优势被压缩;算子匹配方面,3D NAND Flash单次可激活2048×131072的阵列,远大于多数常用算子维度,RC延迟与功耗浪费在无效操作上。
05 多介质异构,成本有望降至HBM方案10%~20%
蔡一茂进一步分析认为,单一NAND Flash存算路径无法满足具身智能等端侧AI的全部计算需求。面向视觉-语言-动作(VLA)模型,LLM需要大参数、低计算访存比,视觉编码模型需要低参数、高算力,动作生成模型需要低参数、低延迟——三类计算需求需要不同存储介质匹配。
他介绍了北京大学团队在RRAM(阻变存储器)方向的积累。RRAM可集成于CMOS后道工艺,读时间短于10ns,能耗约1pJ/bit,完全兼容CMOS工艺。北大与燕芯微已开发出40/28nm高密度高可靠RRAM技术,达到车规可靠性最高等级,写入良率超过99.9%,相关成果已在国内重要集成电路企业40/28/22nm标准CMOS大生产线验证并进入量产。
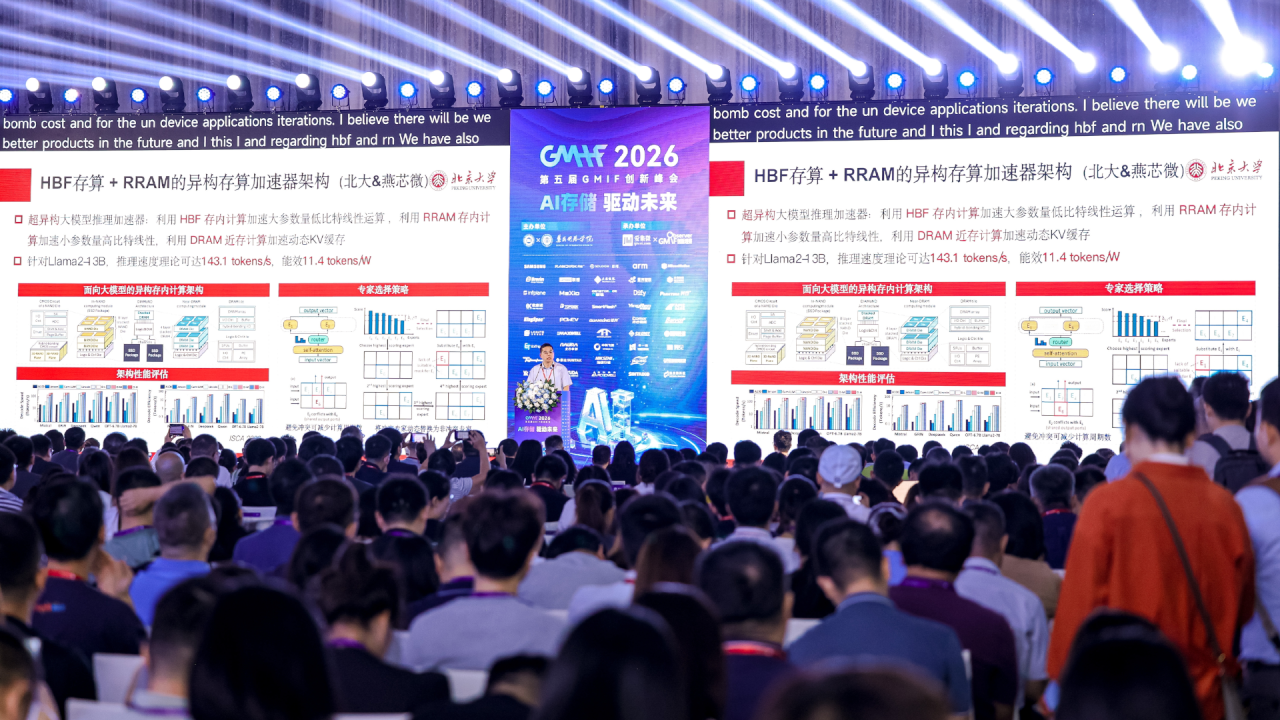
在此基础上,蔡一茂提出“混合多介质超异构存算”架构,利用HBF存算一体的大容量优势加速大模型线性层计算,利用RRAM实现嵌入式存算以处理低延迟视觉编码与动作生成模型,利用DRAM的高写耐久性存储动态KV缓存。针对Llama2-13B模型,该架构理论推理速度可达143.1 tokens/s,能效11.4tokens/W。
蔡一茂表示,用HBF加RRAM加DRAM,性能可能达到HBM方案的85%~90%,但成本有望降至HBM方案的五分之一至十分之一,具有显著性价比优势。
06 从存储到存算一体,迈向三维超异构
蔡一茂在总结中指出,存储器已不能仅作为独立技术来考量,而应置于人工智能生态中综合研判。随着算力需求和存算技术加速演进,传统存储架构将向多介质、多模式的存算一体方向拓展,最终实现多介质融合的三维超异构存算芯片。
他将这一发展路径概括为两个阶段:存算1.0阶段,重点发展端侧高速存算芯片;存算2.0阶段,重点发展混合介质超异构存算芯片。蔡一茂表示,上述目标“并非简单集成长江存储或闪迪的存储颗粒即可实现”,仍面临较大挑战。他指出,其发展前景主要在于成本优势,尤其在HBM价格难以回落的形势下,产业生态将更倾向于接纳HBF。