一、事件速览:7B小模型统一生成与编辑
9月20日,阿里千问宣布开源千问图像系列中兼顾生成效果、推理效率与使用成本的图像模型Qwen-Image-2.1,将文生图与图像编辑整合在同一模型中,视觉生成部分仅7B参数,并原生支持透明图像(RGBA)的生成与编辑。官方将本次更新的特色概括为四点:小模强效,极致价比;原生透明,创改一体;全能编辑,多局保全;真实质感,字雅人美。
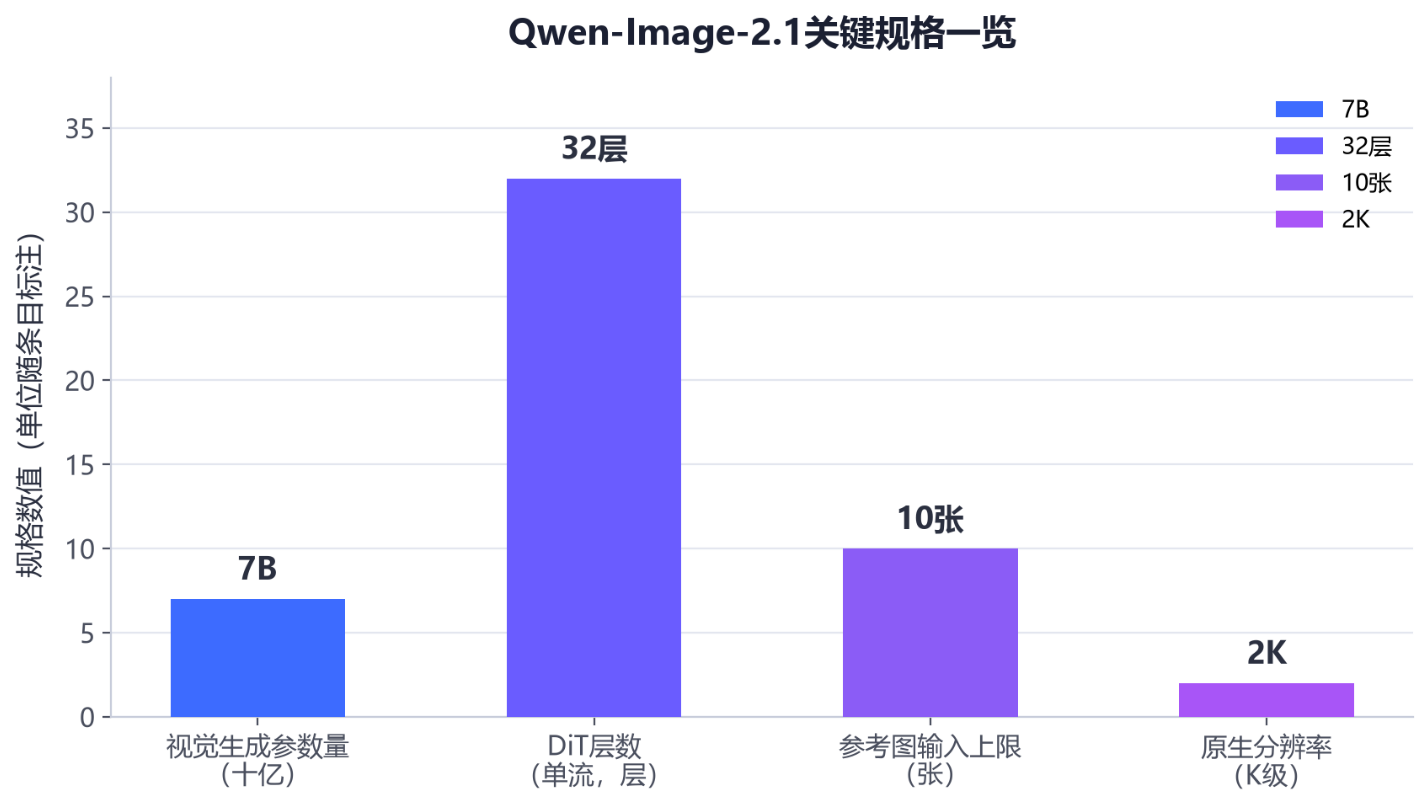
【图表:Qwen-Image-2.1关键规格一览】
权重方面,模型已同步上线GitHub、Hugging Face与ModelScope,Diffusers、ComfyUI、vLLM-Omni、SGLang等主流框架实现首日支持。
二、技术解析:单流DiT与两项轻量推理设计
架构上,Qwen-Image-2.1的视觉生成组件采用32层单流DiT(单流扩散Transformer)架构,参数量为7B,即70亿参数。在较小的模型规模下,模型依然保持了不错的图像生成质量。
为压低推理成本,模型在推理结构上做了两项轻量设计。其一是混合粒度注意力结构,对文本与图像采取不同处理策略:系统前缀与编辑指令等文本部分使用Token级因果掩码,图像生成部分使用Chunk级掩码。其二是前缀KV缓存复用机制,将输入图像与编辑指令作为静态上下文,在首步完成预计算并缓存,以提升推理效率、降低显存开销。官方称,轻量的模型结构与推理优化,使模型在生成质量和计算成本之间取得平衡。
三、原生透明图:生成、编辑与抠图一体
原生透明能力是本次更新的重点之一。模型可以根据提示词自动判断输出普通图像或带透明通道的图像,既能生成单个主体,也能生成由多个元素组成的复杂透明素材。在编辑场景中,用户可以在保持透明背景不变的前提下,只修改主体的表情、颜色或其他局部细节;透明图层中的文字也能被直接替换,例如将图层中的“BLOOM”修改为“Qwen-Image”,其他部分基本没有发生变化。
针对真实照片,Qwen-Image-2.1可以从RGB图像中提取指定主体,并输出带透明通道的RGBA图层,方便后续用于平面设计、商品合成和内容制作。
四、全能编辑:最多10张参考图与多主体合成
编辑维度上,Qwen-Image-2.1最多支持10张参考图输入,可通过圆形、手绘标注或独立遮罩指定局部编辑区域,并保留人物与商品的身份特征。典型场景包括:在多人合照场景中,输入六张人物照片即可整合为一张自然合照,并调整人物姿势与画面光影;在服装搭配场景中,输入模特、衣服、鞋子、包包和帽子等图片,可以生成完整的穿搭效果。
商品编辑方面,模型重点保持商品的文字、纹理和外形,使商品置于新场景后仍能保留原有特征,可用于电商展示、广告素材制作和商品视觉设计;官方案例中,输入手串商品图后整体结构、配色和材质基本保留,但成图中的黑色珠子尺寸略大,与原图相比仍存在细微差异。此外,模型还覆盖全景图、信息图和分镜图生成等任务。
五、质感升级:文字排版与人物光影
质感层面,Qwen-Image-2.1进一步优化了文字生成、字体选择和版式布局,能够生成包含大量图片、文字、图表等多种信息的论文界面,文字清晰、排版合理;在人物表现上,模型增强了光影与细节刻画,使画面更接近真实摄影和商业设计效果。
六、评测表现与行业定位
评测方面,官方公布的Qwen-Image-Bench公开评测显示,Qwen-Image-2.1以7B视觉生成模块取得60.28分,位列开源模型第一,超过Nano Banana 2.0、GPT Image 1.5等闭源模型,落后于GPT Image 2、Grok Imagine 2.0等模型。以7B参数规模跻身第一梯队,是“小模强效”路线的直接注脚,但其与最强闭源模型之间仍有差距。
项目 | 内容 |
发布时间 | 2026年9月20日 |
模型定位 | 统一文生图与图像编辑的开源图像模型 |
视觉生成参数量 | 7B(32层单流DiT) |
原生分辨率 | 原生2K |
透明图支持 | 原生支持RGBA生成与编辑 |
参考图上限 | 最多10张 |
公开评测 | Qwen-Image-Bench 60.28分,开源模型第一 |
开源渠道 | GitHub、Hugging Face、ModelScope |
许可证 | Qwen Research License(非商业,商用需另行授权) |
七、开源生态与产业落地
开源地址方面,模型权重已上架GitHub(https://github.com/QwenLM/Qwen-Image-2.1)、ModelScope(https://www.modelscope.cn/models/Qwen/Qwen-Image-2.1)与Hugging Face(https://huggingface.co/Qwen/Qwen-Image-2.1)。软件生态上,Diffusers、ComfyUI、vLLM-Omni、SGLang等框架实现发布首日支持。
国产硬件侧,壁仞科技基于生成式AI推理框架Diffusers与成熟的BIRENSUPA软件栈,在壁砺166M上快速完成模型适配,率先向开发者提供快速部署方案与高效稳定的体验。
八、系列演进与许可证边界
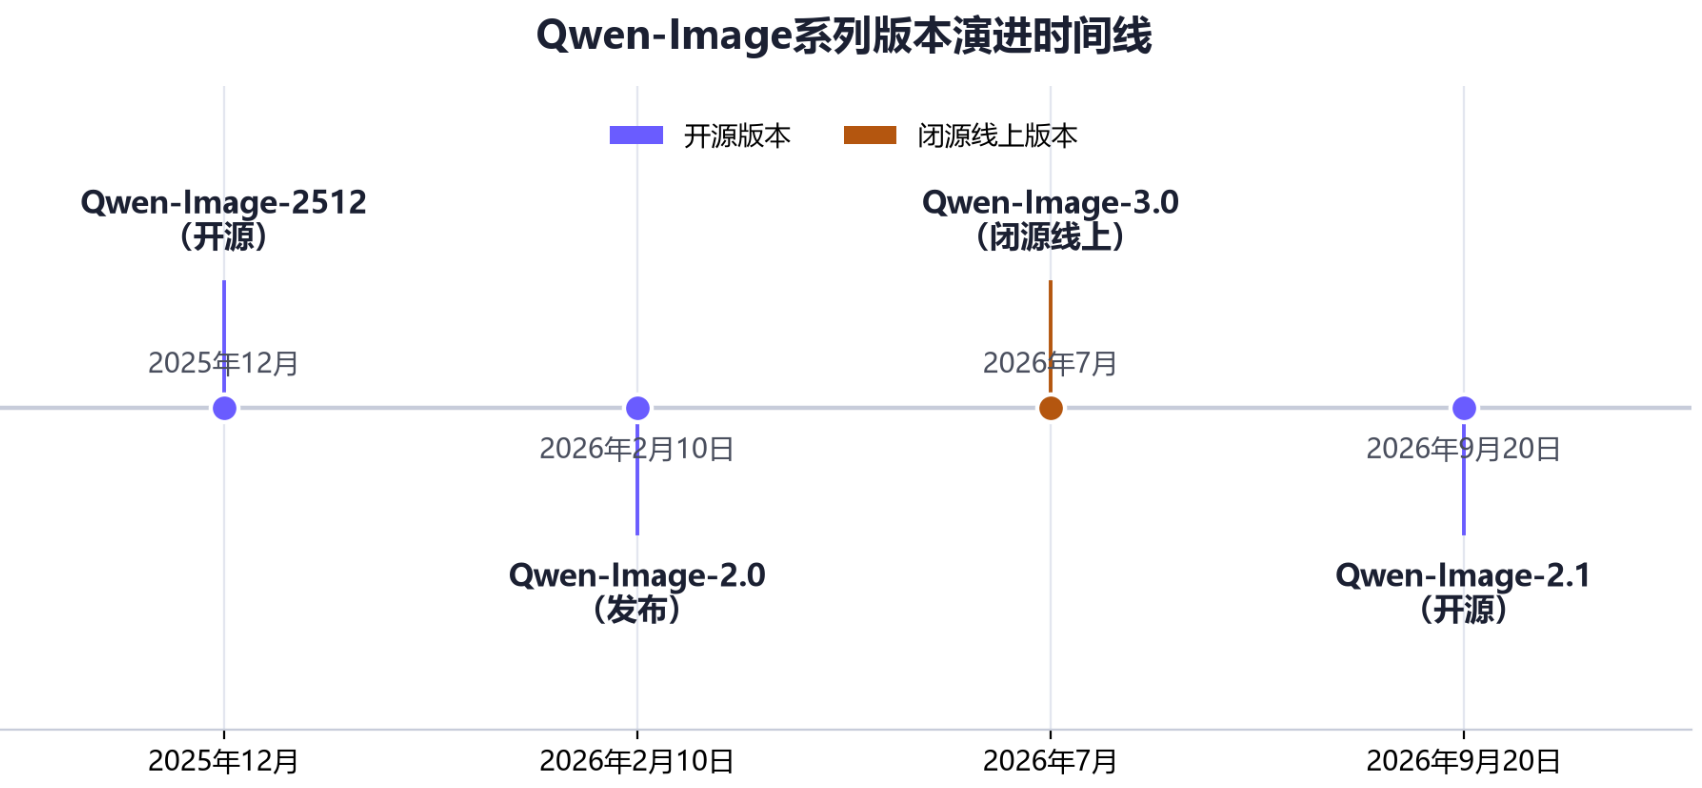
从系列演进看,此次开源距Qwen-Image系列上一次开源已过去约9个月,上一次是2025年12月开源的Qwen-Image-2512;其间,闭源的Qwen-Image线上版本已于2026年7月更新至Qwen-Image-3.0,而2026年2月10日发布的Qwen-Image-2.0曾以2K分辨率与“生图编辑二合一”为主要卖点。
【图表:Qwen-Image系列版本演进时间线】
需要特别注意的是,Qwen-Image-2.1的许可证从此前的Apache 2.0改为非商业的Qwen Research License,商业使用需另行获得授权,“可下载”与“可商用”之间存在明确边界。这意味着开发者可以下载权重开展研究与测试,但若要投入商业项目,则需另行向阿里申请商业授权。
九、结语
Qwen-Image-2.1把透明图像生成、透明图层编辑、多图输入和局部修改能力放进同一套7B模型,进一步降低了图像创作门槛;对设计、电商和内容制作场景而言,透明图与多图编辑可以减少抠图、合成及反复修改的步骤。模型最终能否在本地部署成本、生成速度和复杂编辑效果之间取得平衡,还需要结合实际体验和开源社区反馈进一步观察。
在开源竞争层面,“小模型、强能力、低推理成本”的组合正成为开源阵营对标闭源头部产品的现实路径;而许可证条款从宽松转向非商业授权,也提示开源生态的商业模式正在进入更精细化的阶段。