“不要让算力的僵化,限制算法的进化,算力不应该成为限制算法的枷锁,而应该成为孵化新算法的坚实底座。”天数智芯AI与加速计算负责人单天逸的这句话,道出了这家国产GPU公司对“高质量算力”的理解,也为其挑战英伟达H200写下了注脚。
10月28日,天数智芯2026媒体开放日在上海举行。天垓300首次面向媒体开放实机演示,围绕复杂模型推理、Token工厂、物理AI等场景,与H200在大语言模型、文生图、文生视频等任务上同台对比。据第三方权威机构实测,针对四大主流模型、三类场景,在大模型典型的PD分离部署下,天垓300折算单卡整体端到端吞吐达到H200的1.05倍,成为国内首个在实测中达到H200水平的通用GPU。这一数字比较的不是理论峰值,而是在特定模型和部署条件下整条推理链路的实际输出能力。
H200是英伟达Hopper架构的代表产品,配备141GB HBM3e显存、带宽4.8TB/s,2025年末获美国政府批准重返中国市场,出口每块芯片需向美方缴纳25%的费用。随着H200合法回到中国市场、与国产GPU同台竞争,这不再只是“关起门来的对标”,而是在真实业务场景中接受同一把标尺的检验。国产GPU的竞争焦点也随之变化,从解决“能不能用”的问题,转向比拼实际产出、运行效率和经济价值。
在英伟达凭借CUDA生态和代际迭代构筑的高墙面前,一家成立十余年的国产GPU公司,直面H200乃至更后续产品的竞争,底气究竟来自哪里?
把“对标”写成可复现的实测
H200之所以成为标杆,在于它是大模型推理和复杂计算领域具有代表性的高水平GPU。对国产GPU而言,达到这一水平,意味着跨过一道具有实际意义的性能门槛。
除了第三方权威机构的测试,天数智芯性能实验室的数据进一步覆盖多个典型业务场景:64K长上下文下,天垓300的Attention性能为H200的1.05倍;GLM-5.3模型64K规模下,保障同等用户体验的同时,MoE吞吐为H200的1.15倍;8K至128K长上下文场景下,Agent首字延迟较H200降低约10%—30%;多模态生成推理吞吐相较H200提升约2%—5%;在搜广推等在线业务中,推荐推理吞吐提升21%、轻量计算时延降低26%。
这些指标背后,是用户能感知的体验:长上下文决定长文档分析和复杂Agent能否高效运行,MoE吞吐影响同等服务要求下系统承接请求的能力,首字延迟则直接关系用户发出请求后的等待时间。这意味着天垓300的对标不是实验室里的“峰值竞赛”,而是把性能放进了真实业务链路。
现场实机演示让这种对标从数据走向可感知。单天逸现场对比了天垓300与H200在文生图、文生视频方面的表现,均优于后者。文生图环节,现场媒体指定生成“一个亚麻发色、穿白色连衣裙的女生在冰面行走,赛博朋克风格”的图片,天垓300 4秒就生成了第一张图片。文生视频环节,另一媒体让产品分别生成“豆包穿着骑士装迎娶奶龙”的视频,天垓300的吞吐量指标为0.628,相比H200更高,且任务的完成速度、服务端的推理速度更快。把对比环节直接开放给媒体现场命题,本身就是对实测结果自信的最佳呈现。
训练侧,天垓300也给出了参照。在基于Qwen3-32B模型的8卡整机FP8精度训练演示中,天垓300每卡有效吞吐达到H100的1.33倍。强化学习方面,据条件性工程估算,以1024张卡对已有预训练基座开展一次强化学习,在40B激活参数的中心情景下,约26天可完成约1T总参数MoE模型的500亿生成Token强化学习任务。
这解释了天垓300的第一个底气,它不是只在某一个模块上表现突出,而是在Attention、MoE、Agent时延、多模态、搜广推、训练和强化学习等多类负载上,进入了与国际主流高水平GPU直接比较的区间。
算力竞争变成“系统账本”
如果说1.05倍是性能门票,那么Token工厂则是商业账本。随着日均Token调用量较2024年初增长上千倍,算力规模化落地的热门形态正在从“卖卡”转向“卖有效产出”。电力、机房和固定运维等支出难以随意压缩,单位Token成本很大程度上取决于设备投入和有效吞吐。
过去十年算力规模野蛮生长,但推理场景的平均利用率不足20%,训练场景的平均利用率也仅在40%出头——“理论算力一路飙升,可到了实际应用场景里,效率却大打折扣。”单天逸的比喻颇为直白,“就像我们开车行驶,会面对雨雪冰雹、崎岖土路、蜿蜒山路……幻想奔跑在平坦的赛道上毫无意义,我们要做的是越野车,面对种种不利的场景也能披荆斩棘,一往无前。”
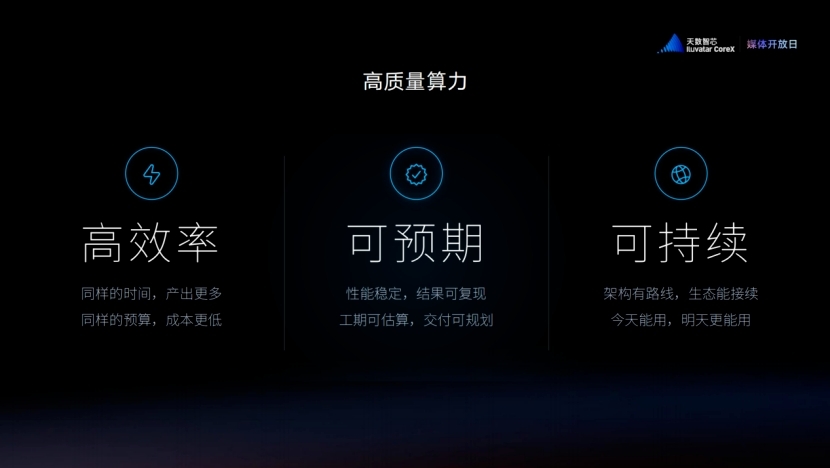
由此,天数智芯把高质量算力概括为三个关键词:高效率——同样投入产出更多有效结果;可预期——长时间运行稳定、性能可复现、部署前可测算;可持续——面对模型和业务的迭代,平台持续发挥作用。天垓300的底气,在于它把单卡性能延伸到了系统效率。数据显示,天垓300满负荷运行的步时波动为0.43%,低于对比Hopper方案的0.76%。这意味着长时间高负载运行更稳定,直接保障利用率和可用率。对Token工厂而言,“跑得快”只是第一步,“长时间不掉链子”才决定商业可持续性。
系统层面,天垓300已形成从加速卡、一机8卡服务器到超节点的完整方案。天垓300 IXL144超节点在单个标准机柜内集成144颗GPU、聚合约10.1TB显存,据测算,其每百万有效Token成本较国际主流方案可降低约40%。其新一代P2P互联引擎目标是将域内单次传输延迟由3—5微秒降至1微秒,并支持统一内存语义编程和大EP,将专家权重分散到更多核心。
天数智芯还试图用“异构”打开另一种可能。天垓300以通用GPU为底座,支持混合训练、PD分离与AFD分离等多种部署形态,可与其他厂商的加速卡、专用芯片协同。在AFD分离方案中,天垓300承担Prefill全流程计算与解码阶段的Attention,合作厂商的XPU承担FFN专家网络,实测Decoding推理延迟可降低60%。据悉,这是国内第一个基于GPU+XPU的异构部署AFD分离方案。
“未来的AI算力系统,不一定由一种芯片包打天下。”单天逸表示,“关键是如何把它们高效组织起来,让整个系统发挥更大的价值。”这句话点出了天垓300挑战H200的第二层底气,它是用一颗芯片包揽所有计算,而是用通用架构和异构协同,把客户已有算力资产组织成更高效率的系统。
把专家经验变成基础设施
硬件性能达到可用区间后,真正的门槛是软件与生态,这意味着开发者能否真正用好,这也正是英伟达最深的护城河。新模型层出不穷,部署、适配和性能调优往往需要经验丰富的工程师投入大量时间。如果软件栈复杂,硬件性能就难以转化为业务价值。
天数智芯的答案,是把AI引入软件栈自身的开发。副总裁、软件开发负责人石加圣首次展示了天数智算软件栈全面拥抱Agentic AI的布局,围绕“易于使用、易于优化、易于开发”三个层次展开,将软件栈、专业工具与工程经验同Agent技术结合,让一线开发者围绕场景目标和服务约束,直接调用工具、复用经验、开展优化。
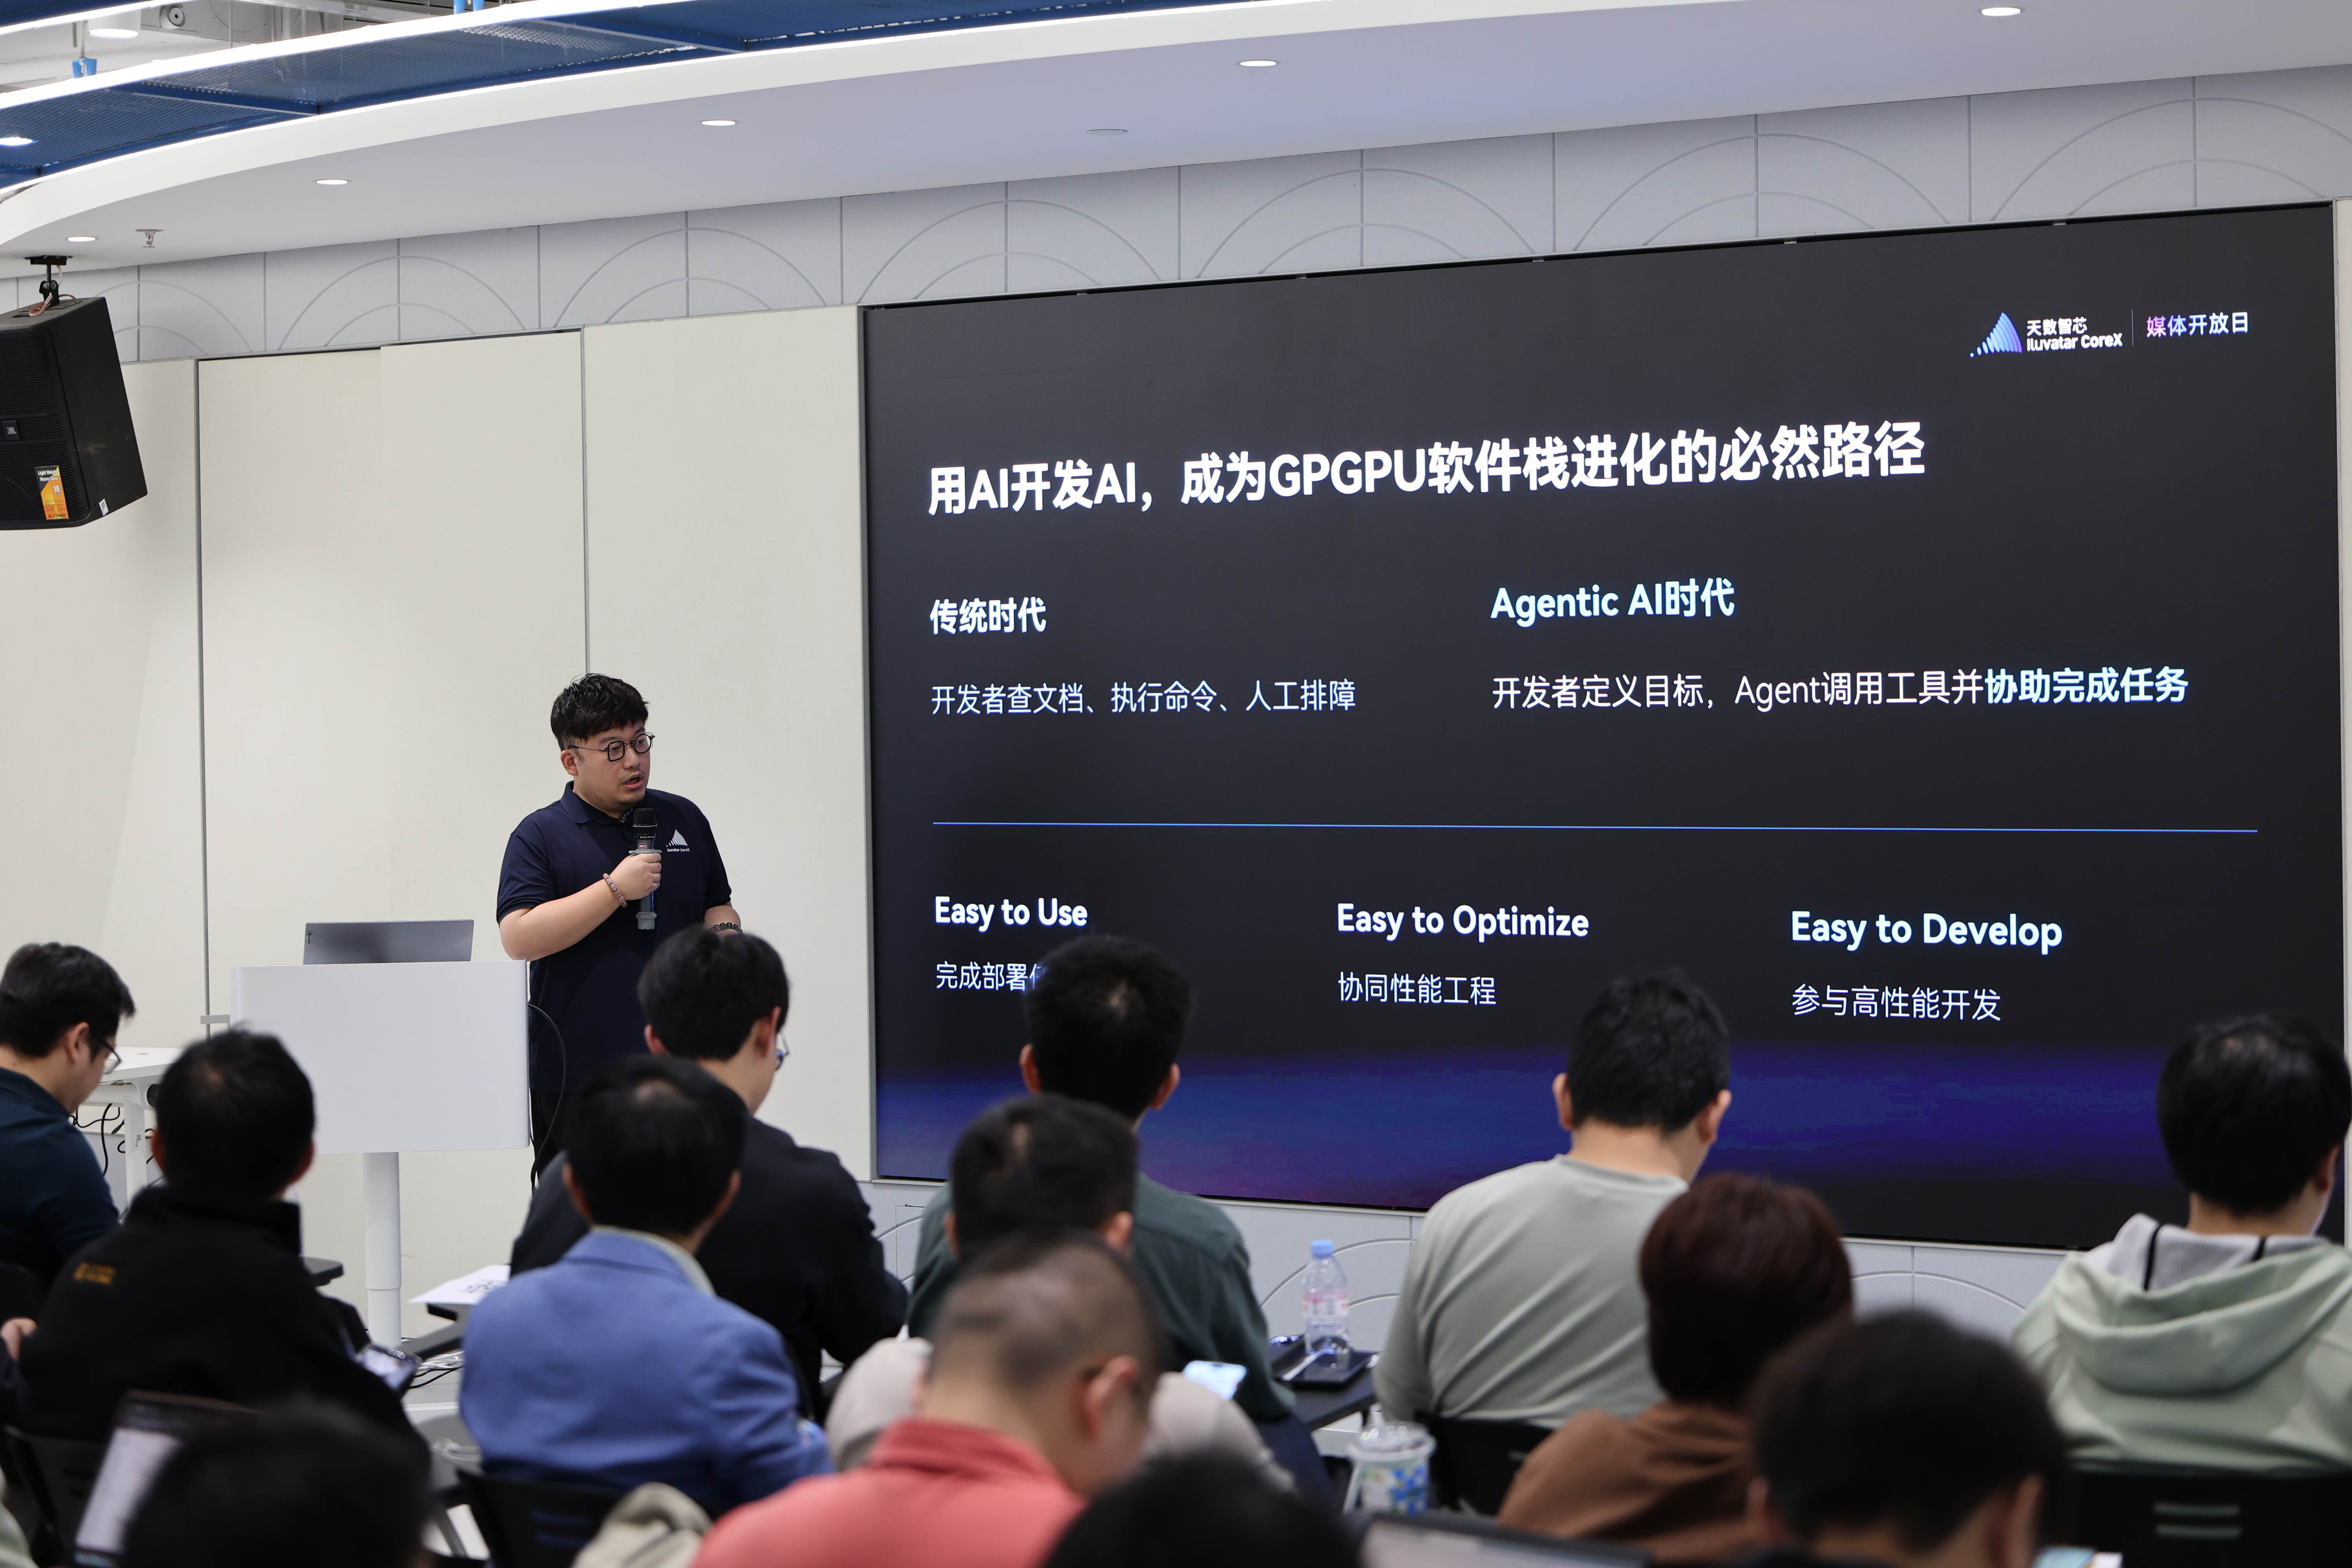
在“易于使用”方面,模型PD分离部署实测中,环境准备与服务部署整体用时由1小时缩短至10分钟,人工操作由数十步减少至1步。在“易于优化”方面,根据某大模型调优任务实测,工作周期由7天缩短至2小时内;在相同硬件、模型和精度要求下,相关任务运行性能较优化前接近翻倍。在“易于开发”方面,作为首家深度接入FlyDSL的国产GPGPU厂商,天数智芯通过Agent与FlyDSL协同,让AI参与代码生成、编译、测试和性能优化;在某主流模型适配与调优实测中,过去10人天完成的工作,现在1人在小时级内就能完成,编译速度提升90%以上。
“Agentic AI让一位工程师的经验,能够持续服务千千万万开发者。”石加圣表示。对国产GPU而言,这不仅是工具效率问题,更是生态问题。把GPGPU工程师在模型适配、性能调优中积累的方法沉淀为可调用的工具与技能,让厂商最稀缺的资产——专家经验——变成客户侧可以复用的基础设施,对CUDA生态的既有惯性而言,这是比“兼容”更进一步的答案:与其让开发者勉强迁移,不如让迁移和调优本身变得足够便宜。
只有当部署、调优和Kernel开发的门槛下降,硬件能力才能更快进入更多模型、更多业务和更多开发者手中。这是天垓300挑战H200的第三层底气——用软件栈把“专家经验”产品化,把单点性能转化为可复制的生产力。
把云端能力“折叠”进方寸之间
天垓300之外,天数智芯还在补齐云边端的另一块拼图。其彤央端侧算力终端TY1200,标称300 TOPS稠密算力,在多组实测中超越了英伟达目前很强的边端产品Thor T5000。
彤央TY1200标称300 TOPS INT8稠密算力,存储配置为32GB系统内存加32GB HBM2e显存;其对比对象英伟达Thor-T5000则为2P FP4稀疏算力、128GB共享内存。资料显示,在Qwen3.8-27B、Qwen3.6-35B-A3B等LLM模型实测中,TY1200性能达到Thor T5000的1.2倍;在Cosmos-R2-2B和Cosmos-R2-8B测试中,TY1200实测性能分别达到Thor T5000的158%和180%。
参数口径并不相同,但活动现场天数智芯彤央产品市场负责人宋远盈同样从真实任务中进行了实测对比。媒体向Qwen3.8-27B模型提问“狮子和老虎单挑谁会打赢”,TY1200的首词延迟更低、吞吐更高、输出时间更短。在文生视频任务中,媒体要求两款产品分别生成“猫咪打架并打碎了花瓶”的视频,TY1200在6分10秒内生成了5秒视频。以更小的内存规格和稠密算力口径,在实测任务中跑出更快响应,这正是天数智芯反复强调“不被标称算力定义”的原因。
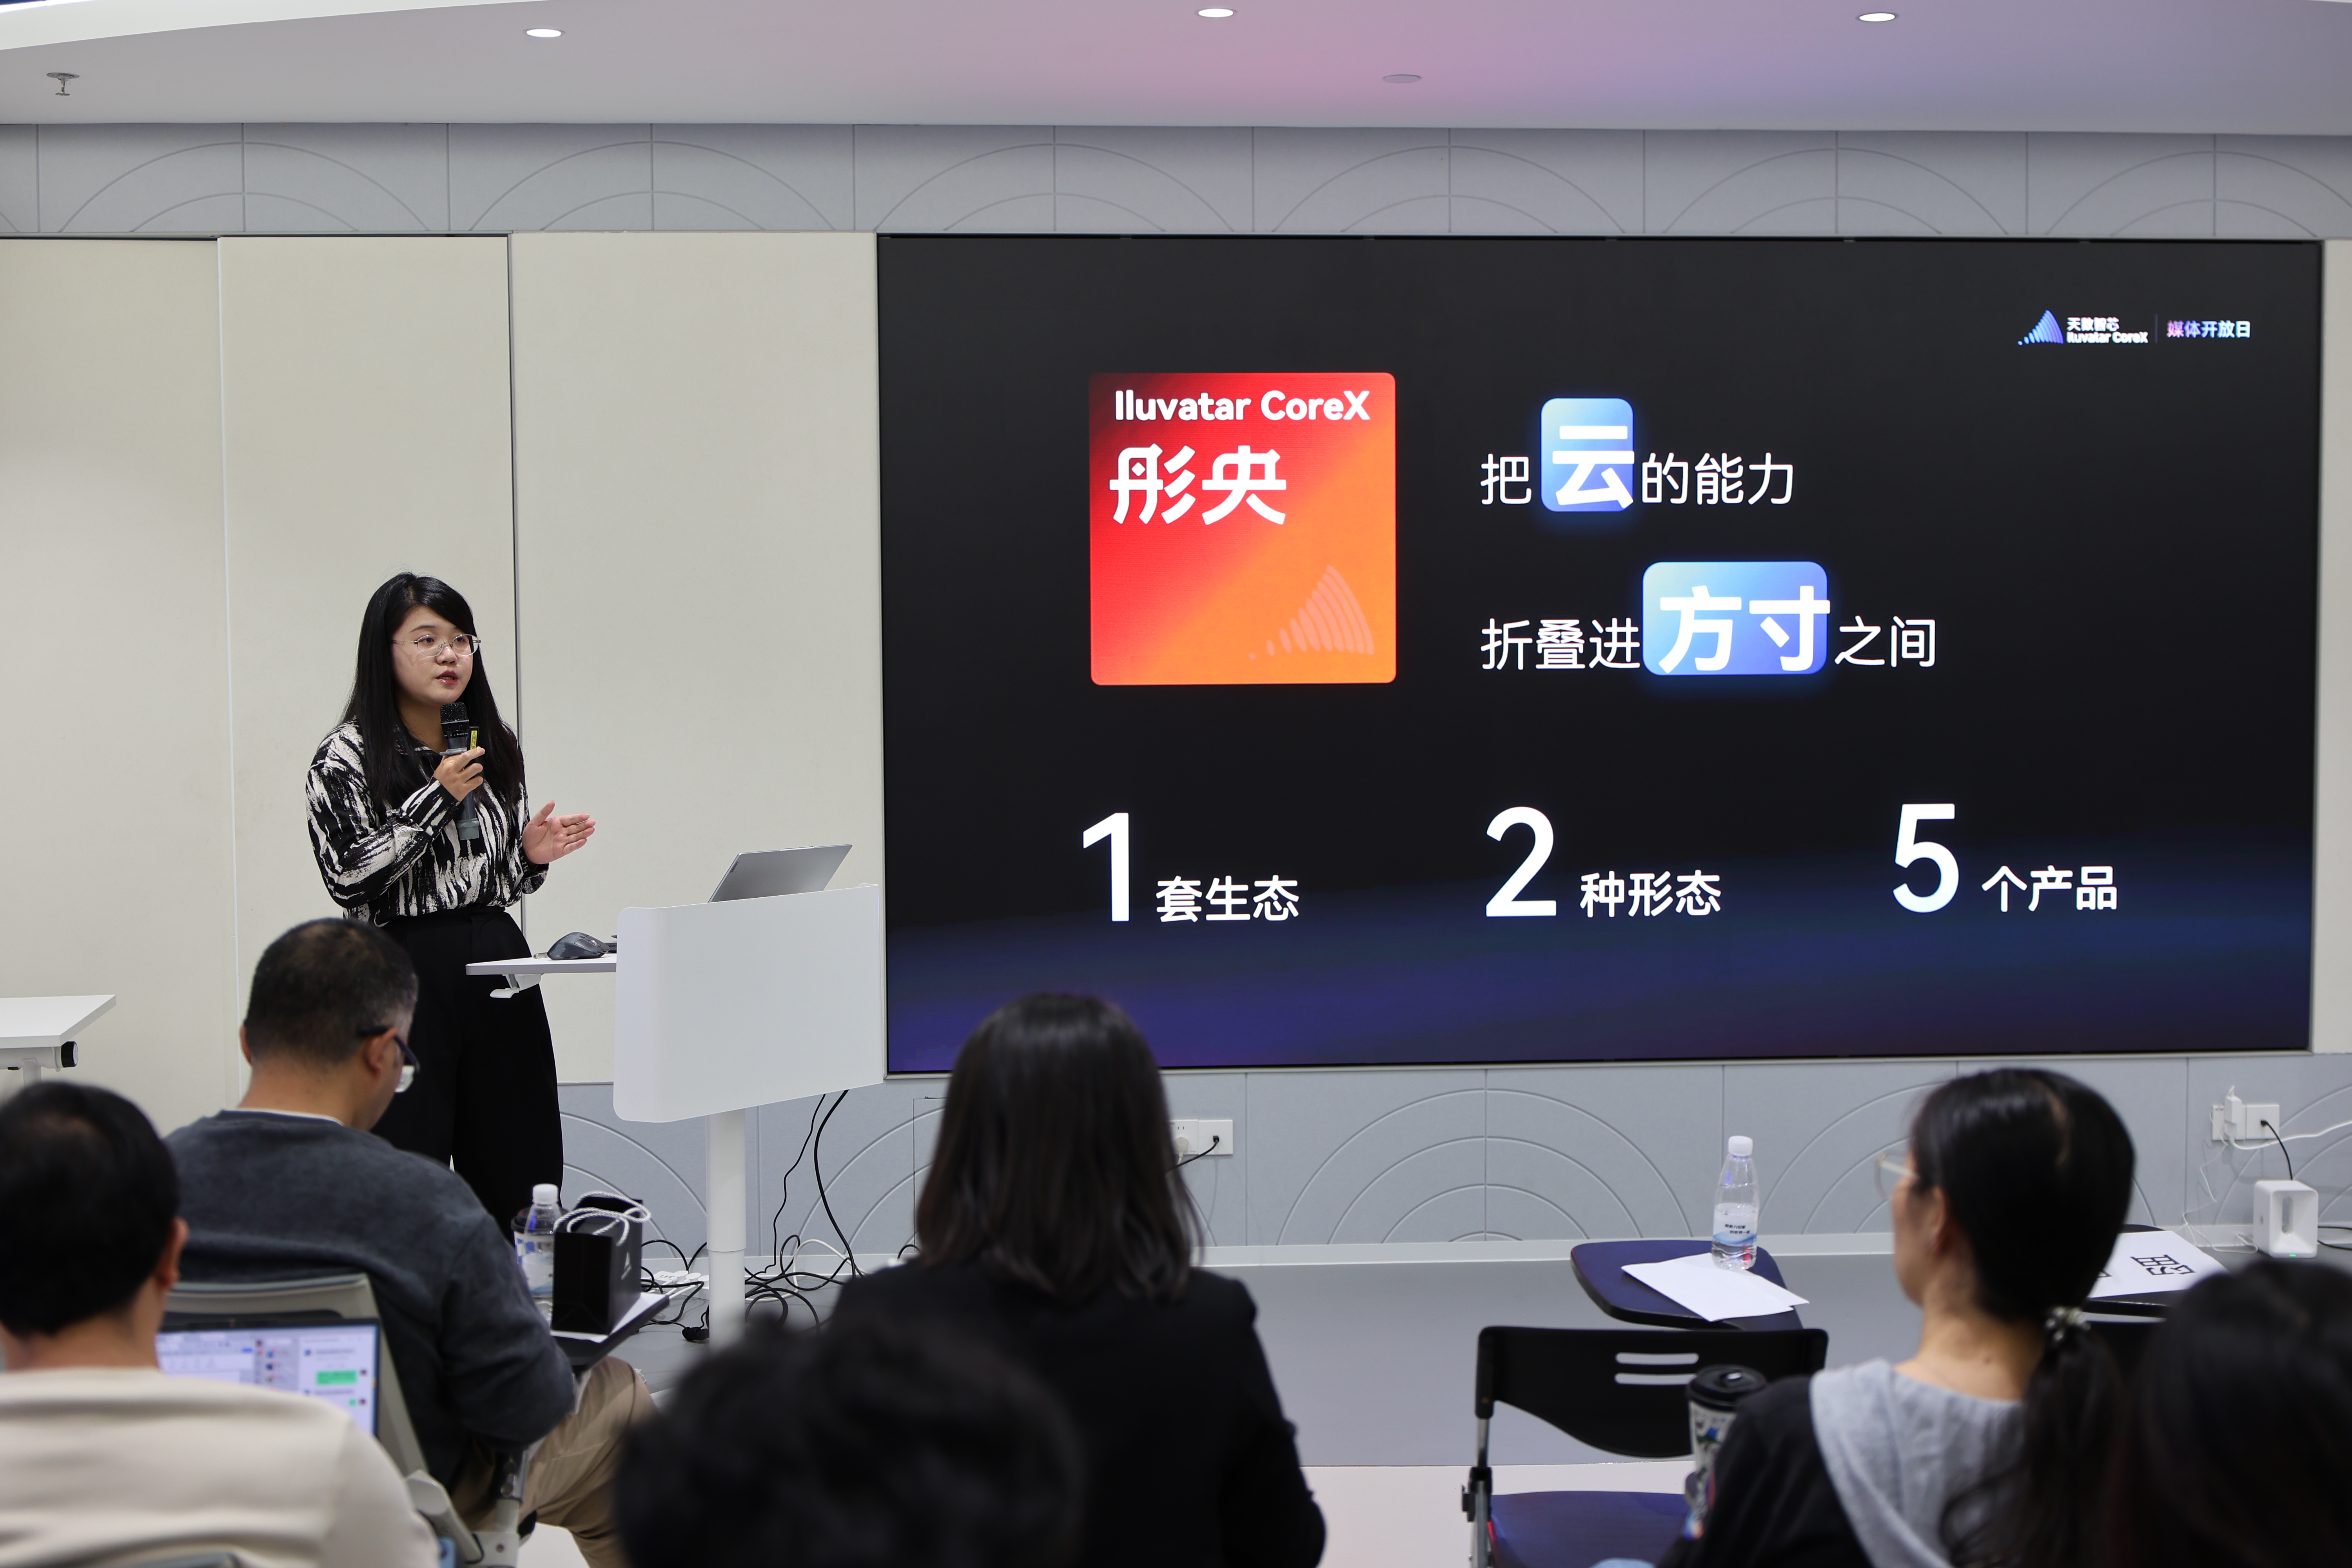
“云端GPU厂商做端侧,不是把芯片做小,而是把能力下沉。”宋远盈表示。天数智芯把云侧大规模训练与推理中积累的模型压缩、量化、蒸馏和软硬协同能力,连同通用GPU架构、编译器、算子库和性能工具带到边端,让模型“生在云、长在边”。
这背后是算力分层的现实逻辑。“算力离数据越近,价值兑现越快。”宋远盈在演讲中强调,而端侧竞争力的上限,由云侧AI全栈能力决定。合同审核、投资BP分析等高保密场景需要“数据不出门”,物理AI和具身智能需要毫秒级响应,简单任务不必都上云,复杂任务也不宜一律下沉。TY1200在储能电芯研究、应急视觉识别、文旅导览、陪诊机器人等场景的落地,说明端侧不是“缩小版云端”,而是高质量算力的新现场。
现场一个颇具意味的细节是,在复刻英伟达GTC柏林展示的MicroDuck机器鸭场景时,天数智芯没有像英伟达那样把训练任务送往云端超级计算机,而是将物理仿真、策略训练和动作验证全部放在离线脱网的TY1200上完成,最终让一只3D打印、手工组装的“手搓版”机器鸭成功站立。宋远盈称,这是首次在国产端侧产品上实现基于MuJoCo-Warp的GPU加速物理仿真。
结语:过线是新的起点
从云端天垓300、天数智算软件栈,到端侧彤央算力终端,天数智芯正在构建一个云边端协同的增强回路。这个回路让高性能计算不止停留在数据中心,更能进入物理世界和行业现场。对天数智芯而言,挑战H200的底气不仅来自一颗芯片,更来自“云有多深,边端就能走多远”的能力迁移。
这份底气,本质上是一套系统能力:把芯片性能、软件效率、异构组织和场景落地,组织成可持续交付的有效产出。现场媒体随机给出的实测考题,正是这套系统能力最直观的注脚。天垓300跨过的,不只是一道性能门槛,更是国产通用GPU走向高价值应用竞争的关键里程碑。
过线,更是新的起点。相信包括天数智芯在内的国产GPU将从“能不能用”迈向“好不好用、能不能规模化用”,以客户真实负载为试金石,在持续交付和长期应用中不断验证价值、兑现价值,打开更大市场空间,书写国产算力高质量发展的新篇章。