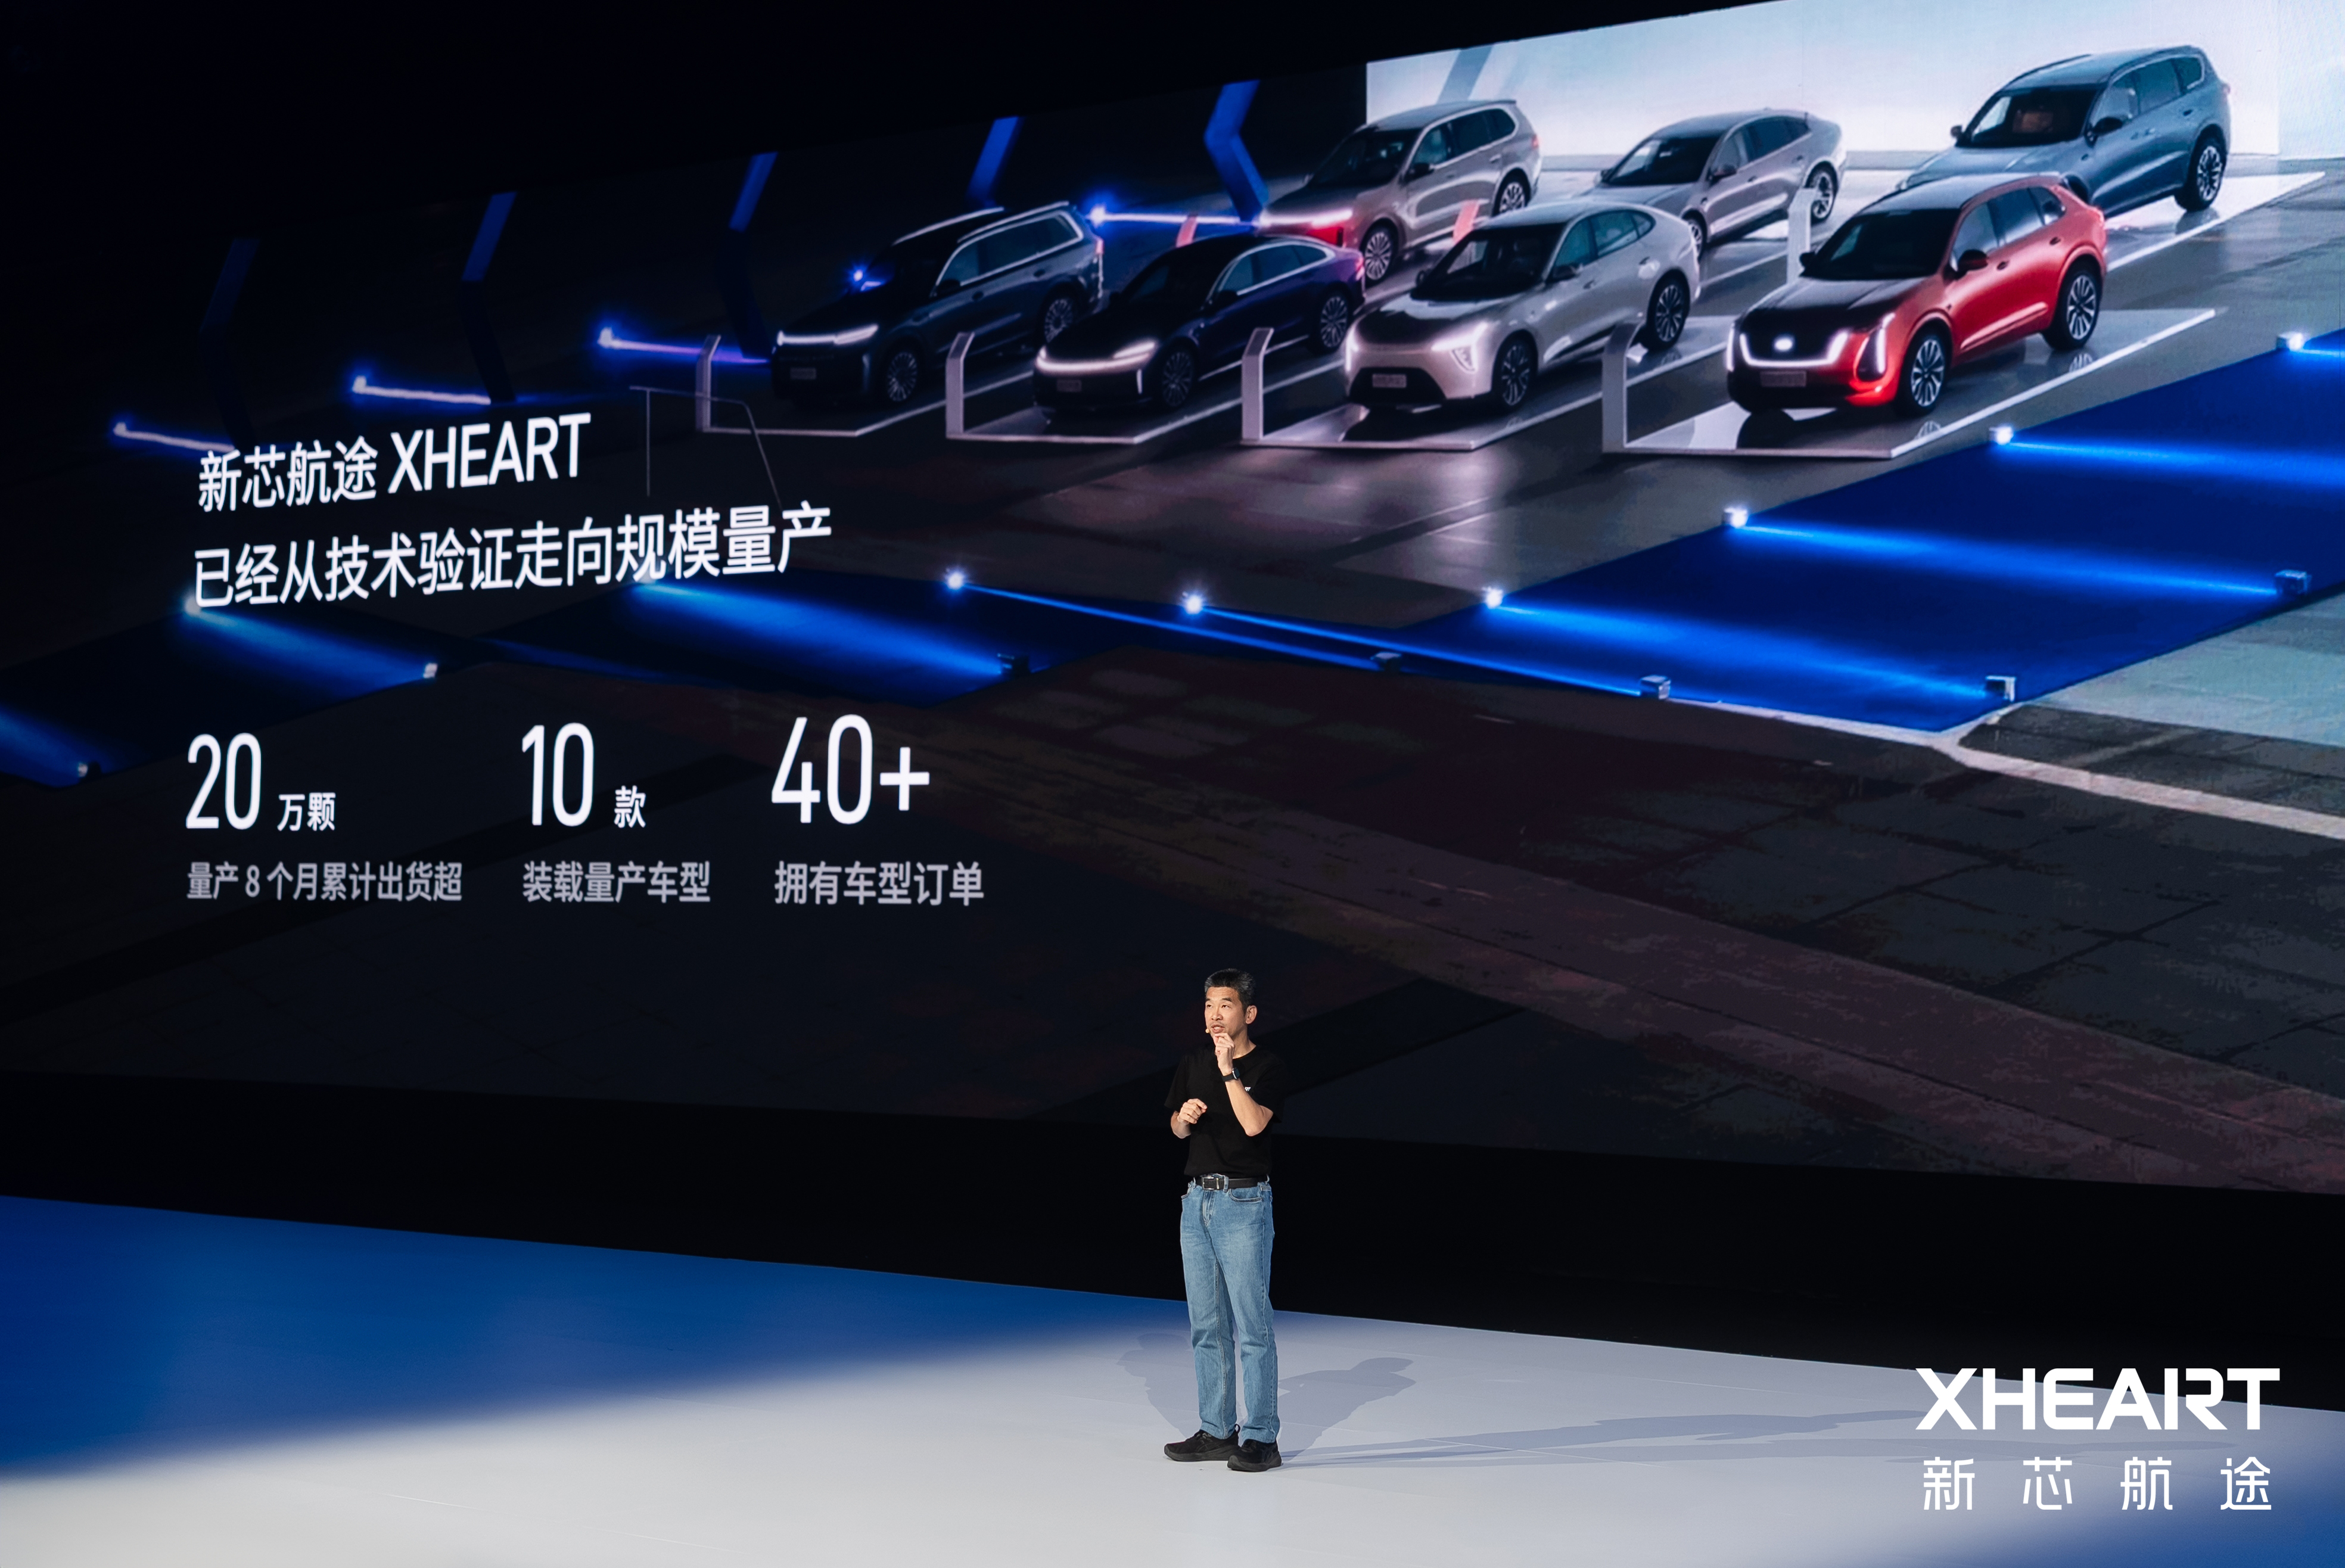
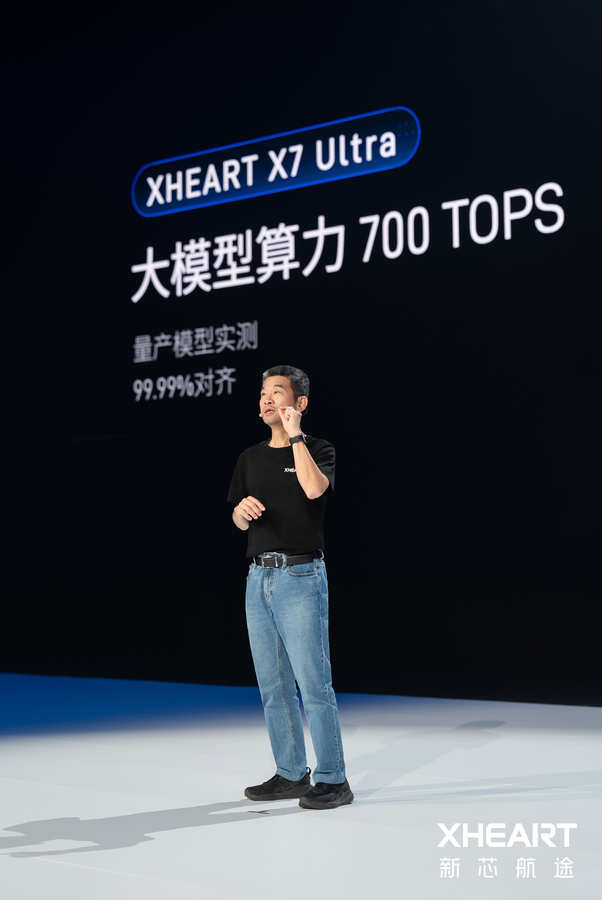
10月29日,XHEART新芯航途在苏州发布大模型芯片X7 Ultra,大模型算力达700 TOPS。
会上,XHEART CEO李宗霖给出一组关键数据:基于量产智驾大模型实测,X7 Ultra的NPU计算利用率达到98.7%;在同等大模型性能下,内存带宽消耗下降80%,推理能效提升100%。当天,Momenta CEO曹旭东站在同一个舞台上,提出了一个更锋利的判断:面向大模型定制的专用芯片,性能可达通用芯片的10倍;而规模化L4需要承载百亿甚至千亿参数的大模型,通用芯片在功耗、车规可靠性与成本之间构成一个“不可能三角”。
表面上看,这是一场芯片与算法联合发布,但一个更深的信号是:智能驾驶的算力底座,正在经历一次从“芯片挑模型”到“模型挑芯片”的范式转移。
旧路径的裂缝,定义权反转
过去几年,智能驾驶芯片的竞争基本沿着一条线展开:制程更先进、TOPS更高、能效比更好,似乎只要芯片的峰值算力足够高,模型总能被“适配”上去。问题出在“适配”二字上。但是,通用芯片在实际自动驾驶模型上的有效算力利用率,往往明显低于峰值。这个差距不是靠堆叠更多TOPS能追平的。
当模型从多个小模型拼接的分布式架构,走向端到端大模型乃至世界模型时,计算的特征发生了质变:注意力机制的访存模式、层归一化的向量计算、大规模参数下的内存带宽压力,与传统的卷积网络推理有着根本不同的硬件偏好。通用芯片的架构设计在模型形态相对稳定的年代是合理的,但当模型本身成为迭代最快的变量时,“先做芯片、再让模型适配”的节奏就开始脱节。一款车规芯片从定义到量产通常需要三到四年,而智驾模型的核心架构在两年内就可能完成一次代际切换。芯片还在流片,它要服务的模型可能已经换了模样。
XHEART给出的解法是颠倒顺序——先理解模型,再设计芯片。李宗霖在发布会上将这一路线概括为“三道题”:算力能否在真实量产模型中充分发挥,今天设计的芯片能否跟上明天的模型,能否在合理能耗下获得所需能力。这三道题对应的,分别是有效利用率、架构前瞻性和能效约束。
值得一提的是,X7 Ultra已具备六大产品优势,专为大模型设计的超大核NPU、硬件并行度解锁、AI工具链重构、中国首发量产Armv9车规级CPU、深度异构计算,以及软硬兼备的安全能力。而基于量产智驾大模型实测,其NPU计算利用率达到98.7%。
上述数据表明了,在大模型时代,芯片的性能瓶颈不再主要位于“算力峰值”这一个维度上,而是分布在计算效率、访存效率和编译效率的乘积里。X7 Ultra相比行业旗舰产品内存带宽消耗下降80%、能效提升100%的数据,说明优化空间恰恰藏在那些被标称算力掩盖的地方。
“不可能三角”,量产是试金石
如果说XHEART是从芯片工程的角度切入,Momenta的视角则来自算法规模化的经济学。曹旭东把规模化L4对芯片的要求归结为一个“不可能三角”:百亿至千亿参数的模型需要海量算力,但车规场景同时约束着功耗、可靠性和成本,通用芯片很难在三个顶点之间找到可行解。他的判断是,唯有从模型需求出发定义芯片,才有可能在约束条件下支撑千亿参数模型。
这一判断需要放在Momenta自身的路线图里理解。Momenta此前已经形成两个洞察:数据驱动解决长尾问题,规模量产获取海量数据。第三个洞察“大模型定义芯片”补上了从数据到车端推理的最后一环。R7 Ultra参数规模扩大5倍、安全性能提升5倍,以及“推演万物”能力的涌现,不是算法单方面的进步,而是算法与X7 Ultra的计算特性对齐之后释放出的增量。曹旭东称大模型定义的芯片相比通用芯片性能提升10倍,这个“10倍”如果理解为有效性能而非标称算力,与X7 Ultra在利用率和能效上的数据是自洽的。
但这条路径的成立有一个容易被忽略的前提:芯片公司必须深度理解模型,或者与理解模型的算法公司形成足够紧密的协同。而量产数据提供了一定程度的验证:X7系列量产8个月出货超过20万颗,搭载10款量产车型,获得超过40款车型订单;首颗芯片回片不到24小时点亮,第17天实现芯片、底层软件与智驾模型的整车闭环。
“大模型定义芯片”指向的其实是一次权力关系的重新分配。过去,芯片的规格表是起点,模型工程师的工作是在给定的算力、带宽和工具链约束下寻找最优解;现在,模型的架构和迭代节奏成为起点,芯片的架构选择、工具链设计和量产节奏需要向模型的不确定性“让渡”空间。
量产数据之所以关键,是因为它把“定义”从设计文档拉回到真实道路,说明这条路线至少已经跨过从样片到规模交付的门槛。围绕客户量产需求,XHEART提供经过充分验证的解决方案参考设计,帮助客户降低开发难度、提升交付效率。基于双X7的L3/L4计算平台也已获得多个车型项目定点,推动大模型芯片从辅助驾驶向更高等级自动驾驶应用落地拓展。
上述进展的意义不在于数字本身,而在于它们为“模型定义芯片”提供了可检验的样本:芯片是否真的在量产模型上把算力用出来了,是否真的在能耗约束下支撑了更大参数量的模型。
开放平台的考验,X9“提前量”
XHEART的定位是面向多家车企和算法方案商的开放芯片平台。这意味着它需要在Momenta之外,证明X7 Ultra对更广泛的模型形态,包括不同参数量、不同算子组合、不同精度需求——同样具备适应能力。
要知道,开放平台的难点在于,算法公司的模型路线并不统一,有的偏向端到端大模型,有的仍在探索世界模型与规则方法的混合架构,芯片的工具链和算子库必须足够灵活,才能在不牺牲利用率的前提下覆盖这些差异。
XHEART预告的下一代芯片X9指向了更远的判断:3000 TOPS大模型算力、700GB/s单芯片内存带宽,计划2027年推出。内存带宽的权重被明确拔高,与当前行业对“内存墙”正在取代“算力墙”成为端侧大模型首要瓶颈的判断一致。Batch size在车载场景中通常只能设到1到4,大量算力在等待数据搬运的过程中空转,存储带宽而不是TOPS,正在成为决定端侧大模型能否高效运行的那块最短木板。
X9的规格表说明XHEART自己也在修正“大模型定义芯片”的内涵:如果说X7 Ultra定义的是对当下Transformer推理的适配,X9定义的则是对下一代世界模型计算密度的预判。随着世界模型持续演进,更大规模的模型对芯片计算、存储和带宽提出了更高要求。X9将延续“大模型定义芯片”的技术路线,围绕下一代世界模型推进软硬协同设计,通过计算与访存能力同步提升,让更大的模型高效运行,让更强的算力充分释放。
会上,李宗霖表示:“XHEART将保持“量产一代、开发一代、预研一代”的研发节奏,扎实完成各阶段研发与验证。”
未来,“大模型定义芯片”不会消灭TOPS的竞争,但它会改变竞争的含义。当有效利用率的差距可以横跨数十个百分点时,纸面算力的边际价值在下降,而“让每一个算力周期都被模型的真实计算需求填满”的能力在升值。X7 Ultra的98.7%是一个需要量产时间和更多车型来检验的数字,但它至少把一个问题摆到了台面上:在端到端大模型定义汽车体验的时代,一颗芯片真正的竞争力,或许不在于它标称能算多少,而在于它有多不愿意浪费。