导语
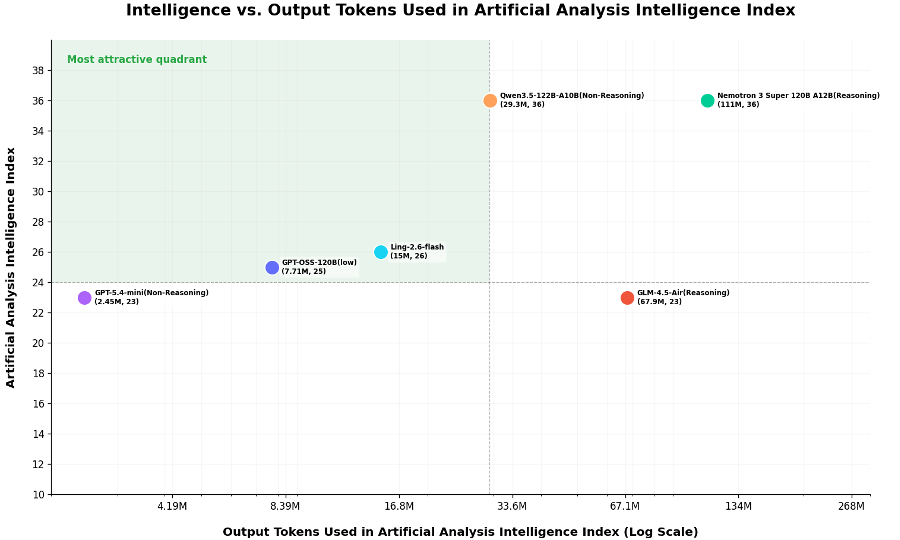
10 月 28 日,蚂蚁集团旗下百灵大模型团队(InclusionAI)正式官宣开源开放权重大模型 Ling-3.1-flash-1019,并同步放出基础模型 Ling-3.1-flash-base。新模型总参数 560B、每 token 激活 25B,支持 100 万 token 上下文窗口,采用极为宽松的 MIT 许可证;在第三方评测机构 Artificial Analysis 的智能指数 v4.3.2 中得分 44,较上一版本 Ling-3.1-flash 的 41 分提升 3 分。官方将这一版本明确导向 Personal Agent 场景——面向复杂工作流与多步骤长程任务的执行能力,而不仅仅是问答对话。从 10 月 22 日仅开放 API,到 10 月 27 日权重上线 Hugging Face,前后相隔仅五天,开源节奏之快在国产大模型阵营中并不多见。
一、从 API 到开放权重:五天的发布节奏
把这次发布的关键时间点排成一条线,可以看清蚂蚁百灵的开源推进方式。10 月 22 日,官方在 X 平台公布 Ling-3.1-flash-1019 的 Artificial Analysis 智能指数得分——44 分,并表示即将开放该模型的权重和 API,当时仅 API 可用。北京时间 10 月 27 日 13:46,Hugging Face 仓库创建,模型卡上线,列出的核心规格为 560B 总参数、每 token 激活 25B、1M token 上下文窗口;19:23,ModelScope 出现同名镜像,仓库元数据显示许可为 MIT,权重分为 54 个 safetensors 分片;20:44,官方账号 Ant Ling 发帖宣布"Ling-3.1-flash-1019 现已开源",同时说明一并放出可继续训练的基座 Ling-3.1-flash-base。约 25 分钟后,Hugging Face 工程师 Adina Yakup 发帖确认权重已放出,并附上仓库链接。10 月 28 日,TechWeb、InfoQ 等中文科技媒体经官方渠道确认正式开源。
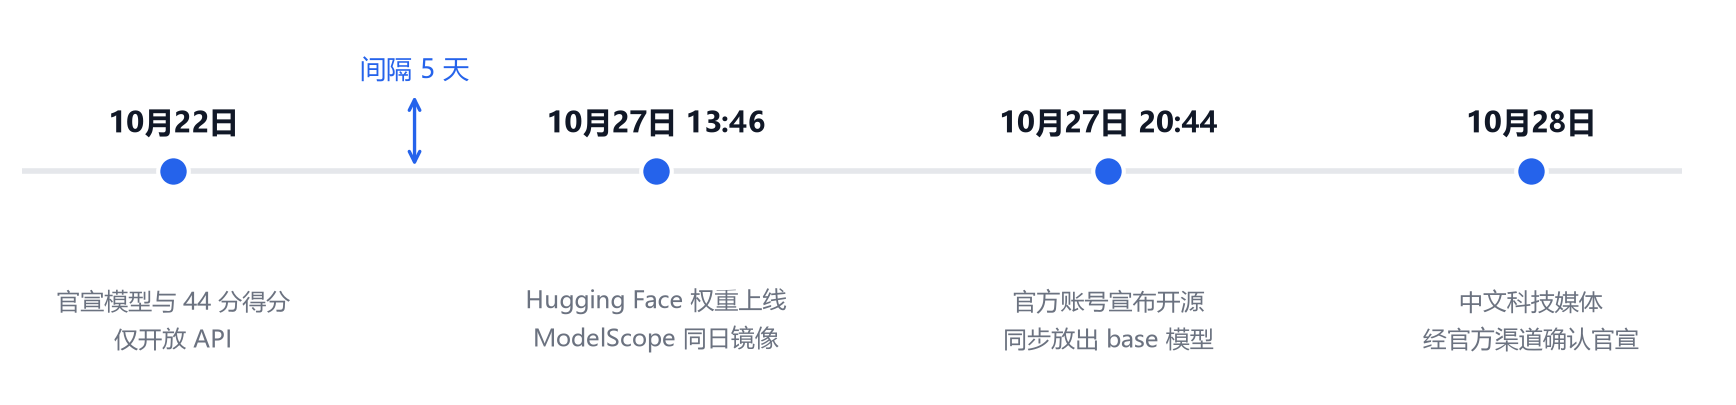
图 1 Ling-3.1-flash-1019 从 API 先行到权重开源的时间线
值得注意的是,这并非蚂蚁百灵的第一次开源动作。据行业报道,上一版本 Ling-3.1-flash 已于本月中旬开源,主打低卡数部署与 1M 上下文;今年 4 月以来,2.6-flash、2.6-1T、3.0-flash、3.0-tiny 等型号也沿"先 API、后权重"的路径推进。开源正在从单点动作变成蚂蚁百灵的产品线惯例,而"1019"这个以日期命名的版本号本身,也暗示了其快速迭代的定位。
二、规格拆解:560B 总参、25B 激活与混合线性 MoE
Ling-3.1-flash-1019 延续了上一版本的混合线性 MoE(Mixture-of-Experts,专家混合)架构。根据模型卡信息,模型由 63 层 KDA 线性注意力层与 9 层 Gated MLA(门控多头潜在注意力)层组成,比例约为 7:1;路由专家共 512 个,另设 1 个共享专家,每个 token 激活其中 8 个。"560B 总参数、25B 激活"的组合意味着:模型整体保有大规模参数带来的知识容量,但每次推理只动用其中一小部分算力,以此压低单次推理成本——这也是"flash"命名所指的方向。
架构上的另一要点是线性注意力的占比。63 层线性注意力层负责在超长上下文下压低计算与显存开销,而少数全注意力层(Gated MLA)用于保住检索精度。两者叠加,配合 1M token 的上下文窗口,对应的是长文档处理、大型代码库分析等长程场景。模型卡列出的推荐部署方案包括 SGLang 与 vLLM,运行在八卡 GPU 节点上。
许可方面,两款模型均采用 MIT 许可证——这是限制最少的开源许可证之一,对商业使用、修改与再分发几乎没有约束。对开发者与企业而言,"能不能商用、能不能继续训练"往往比榜单分数更关键,MIT 加上 1M 上下文,构成了这次发布中最实质的开放姿态。
三、评测提分:面向 Agent 任务的数字
官方与第三方评测给出的数字如下:Artificial Analysis 智能指数 v4.3.2 得分 44,较上一版本的 41 分提升 3 分;复杂知识工作评测 AA-Briefcase 从约 1400 Elo 提升至 1524 Elo;GDPval-AA 从约 1618 Elo 提升至 1644 Elo;流程自动化评测 AutomationBench-AA 从 62% 提升至 68%;科学问题求解 CritPt 从 18% 提升至 26%;SciCode 从 54% 提升至 57%。
表 1 Ling-3.1-flash-1019 与上一版本主要评测对比
评测项目 | 上一版本 | Ling-3.1-flash-1019 | 提升幅度 |
Artificial Analysis 智能指数 v4.3.2 | 41 | 44 | +3 分 |
AA-Briefcase(复杂知识工作) | 约 1400 Elo | 1524 Elo | 约 +124 Elo |
GDPval-AA | 约 1618 Elo | 1644 Elo | 约 +26 Elo |
AutomationBench-AA(流程自动化) | 62% | 68% | +6 个百分点 |
CritPt(物理推理) | 18% | 26% | +8 个百分点 |
SciCode(科学代码) | 54% | 57% | +3 个百分点 |
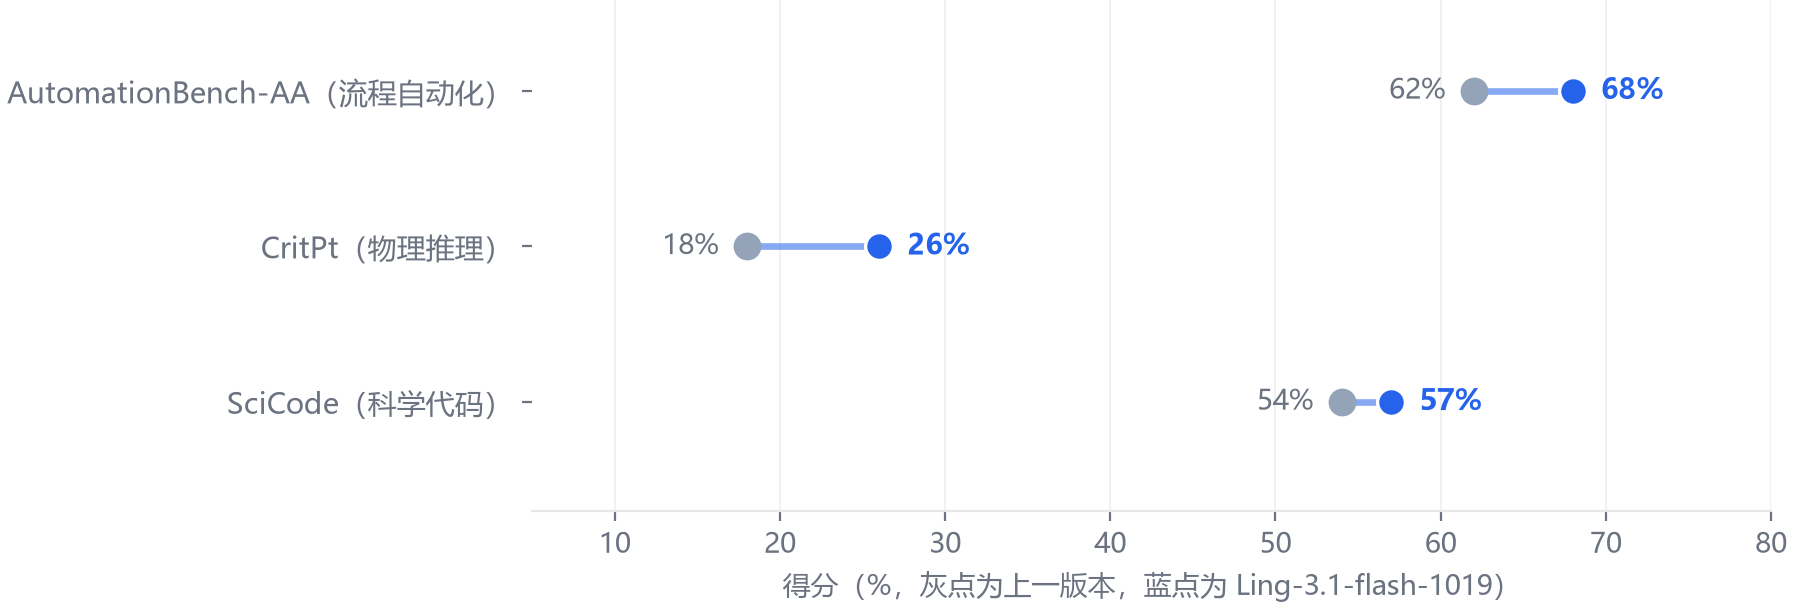
图 2 百分比类评测的提升幅度
从提升结构看,涨幅最大的是流程自动化与复杂知识工作类评测,这正是 Agent 执行任务的直接对应面;相对而言,CritPt 提升至 26% 后仍处于较低水平,物理推理依旧是短板。这一涨一滞之间,可以大致读出这次后训练的重点所在:强化的是工具使用、多步骤执行与真实工作流建模,而非全能型的推理跃升。
四、同步放出 Base:把后训练的起点交还开发者
比指令模型本身更值得关注的,或许是同步放出的 Ling-3.1-flash-base。这是一个未经完整指令对齐与后训练的基础模型,以 BF16 原始精度发布。开发者可以在其上继续预训练、做行业微调或强化学习,而不必从已经对齐的聊天模型出发——后训练与领域适配的起点,被交还给了开发者自己。
蚂蚁官方称,在其自测的 47 项覆盖知识、推理、代码、数学与长上下文等八类领域的基准中,Ling-3.1-flash-base 有 32 项超过 DeepSeek-V4-Pro-Base 与 MiMo-V2.5-Pro-Base。需要说明的是,这一对比为厂商自报数据,尚待第三方复测印证。但从产品策略看,以 BF16 原精度、MIT 许可放出 base 模型,降低的是二次预训练的门槛——竞争的焦点正在从榜单分数转向开发者生态。
五、与灵光 2.0 的呼应:Personal Agent 需要什么样的模型
这次模型迭代与蚂蚁的 AI 助理应用灵光密切相关。就在 10 月 27 日,灵光 2.0 升级为"能管事的个人 AI 助理",依托跨会话记忆、长程任务调度与独立云主机等能力,在用户授权范围内更主动地跟进任务,即使用户退出对话,相关任务也能继续运行。官方给出的例子包括:规划旅行时不只生成行程攻略,还要结合出发时间持续跟进天气、预约和行前准备;面对购物需求,则按预算与个人偏好筛选商品、整理清单并持续关注价格变化。
从"回答问题"到"持续办事",对底层模型提出了不同的能力要求:理解目标、使用工具、处理执行过程中的新信息,并围绕一个目标持续工作。百灵团队表示,团队还训练了视觉语言变体 Ling-3.1-flash-VL,目前已用于灵光,后续将公开发布。模型开源与应用升级在同一周内先后落地,二者之间的配合关系相当清晰:应用层定义 Agent 能力的需求,模型层以开源权重提供可定制的底座。
六、信息边界与冷观察
对这次发布,有几处边界需要如实呈现。其一,评测数字中,仅 Artificial Analysis 智能指数 44 分来自第三方机构,其余均为厂商自报;其二,Artificial Analysis 模型页面将这款模型的发布日期记为 10 月 22 日,而权重实际于 10 月 27 日上线,两处时间口径不同,源于"API 发布"与"权重开源"是两个节点;其三,560B 总参数、八卡节点推荐配置意味着本地部署仍需要相当规模的算力,1M 上下文与低激活参数降低了推理成本,但并没有把部署门槛降到消费级。
更宏观地看,这次发布折射出开放权重阵营的两个趋势:一是旗舰级模型的开放权重化正在加速,从 API 先行到权重放出,间隔以天计;二是竞争重心从单一榜单分数转向"许可 + base 模型 + 生态"的组合。对开发者而言,一个干净的 MIT 许可、可继续训练的 base、可控的激活算力,加之一百万 token 的上下文,构成了一套值得认真评估的开放选项;至于其在真实 Agent 任务中的稳定表现,还有待更长时间与更多第三方验证给出答案。