英伟达200亿美元实质性收购Groq后,其下一代LPU芯片架构拟弃用SRAM转向3D堆叠DRAM(3DS),利用TSV垂直互连在保持标准DRAM接口下扩大容量。其500MB SRAM仅为Rubin HBM容量的1/500,无法承载千亿级模型。AI推理芯片的内存层级正走向混合化。
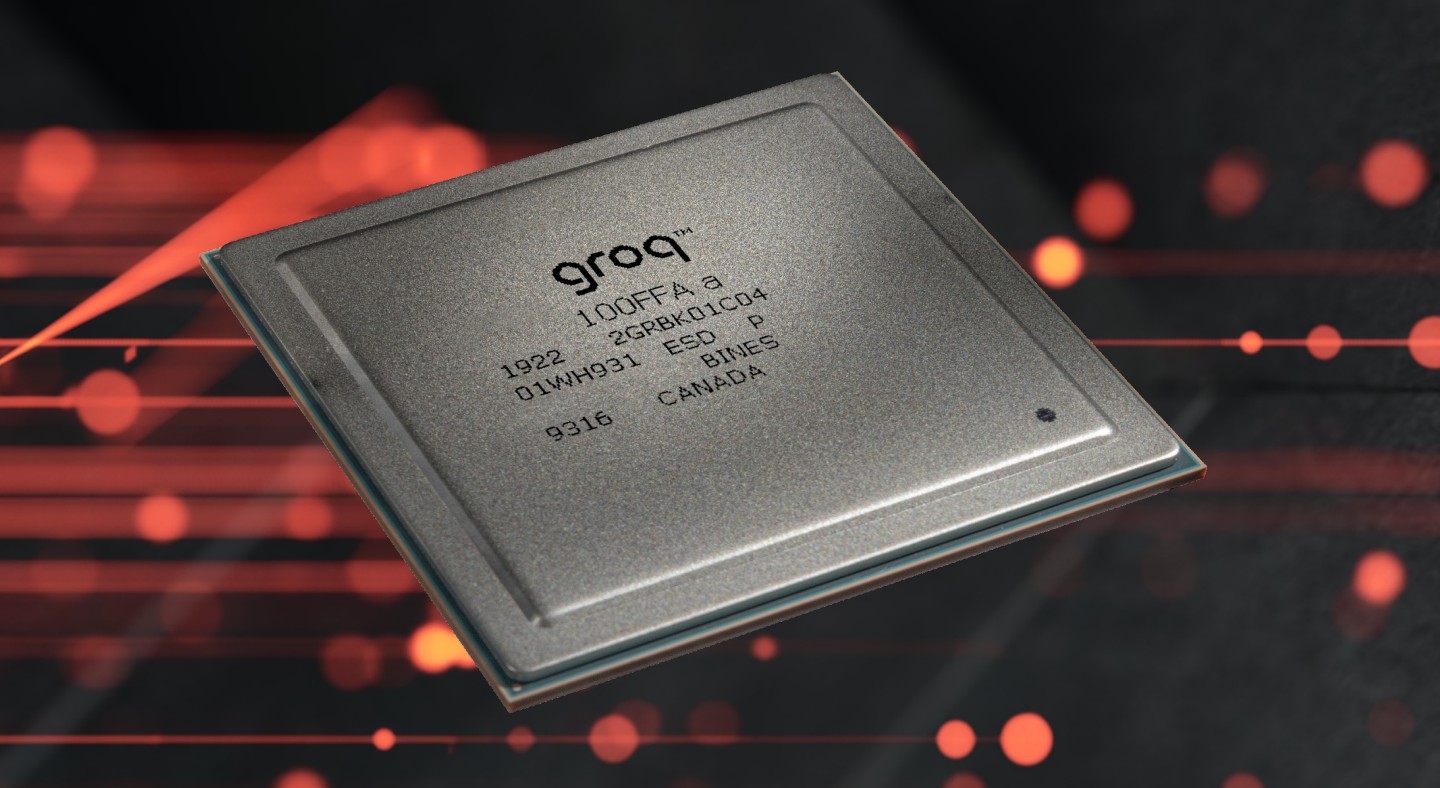
200亿美元后的第一记重拳:从SRAM到3DS的架构急转
AI半导体领域正传出架构剧变的信号。据韩国媒体ZDNet Korea援引半导体业界消息称,被英伟达实质性收购的AI芯片公司Groq,正考虑在下一代芯片中放弃沿用至今的SRAM方案,改用3D堆叠DRAM封装技术。
这笔交易的背景值得回顾。Groq由谷歌TPU设计者Jonathan Ross于2016年创立,2025年12月被英伟达以间接方式收购并签订技术许可协议。这笔交易价值约200亿美元,是英伟达32年历史上最大手笔——远超2019年69亿美元收购Mellanox的纪录;其精妙之处在于结构设计:英伟达并未全资收购Groq,而是通过“非独家技术许可协议”获得其推理芯片技术,同时将创始人Jonathan Ross及核心团队收入麾下,Groq公司本身继续独立运营——这一安排既规避了潜在反垄断问题,也完成了技术吸收。据SEMI数据,2026年推理算力在全球AI基础设施中的占比已首次超过70%,而英伟达在推理芯片市场的份额已从66%攀升至74%——从训练端向推理端延伸,正是这笔交易的战略底色。
如今收购后的首次架构出手,方向出乎很多人意料。目前AI芯片多采用2D封装,Groq计划引入3D封装,将多个半导体裸片垂直堆叠,方案名为3DS(3D Stacked Memory)——利用TSV(硅通孔)技术在DRAM芯片内部打穿数千个微型孔洞进行垂直互连,如同为存储器建起摩天大楼、通过垂直电梯连接各层,在单位面积内提供远超传统设计的显存密度。用行业内部人士的话说,这是要让芯片“像积木一样向上生长”,在维持较小芯片面积的同时提升电力传输效率和存储容量。
SRAM的极限:500MB对288GB的悬殊差距
要理解这次转向,得先理解Groq此前的立身之本。Groq的LPU(语言处理单元)架构以极高推理速度闻名:现行主力产品Groq 3 LPU采用大容量SRAM设计,每颗芯片集成约500MB片上SRAM,内存带宽最高150TB/s,韩媒TheElec称这比HBM快7到45倍。技术上,SRAM相比DRAM的访问延迟不是“略快”,而是快一个数量级——典型HBM/DRAM延迟约100纳秒,SRAM仅需1纳秒。当模型权重直接驻留在SRAM中,不再需要缓存猜测与等待,延迟瓶颈便从物理层面被打破。系统层面,英伟达在GTC 2026上发布的Groq3 LPX机架采用全液冷设计与MGX基础设施,集成256颗LPU、片上SRAM合计128GB、对应40PB/s的SRAM带宽,定位为Vera Rubin平台的AI推理加速器,可使该平台每百万瓦电力支撑的推理吞吐量提升最高35倍。
但SRAM的长项是速度,代价是容量、成本与芯片面积。SRAM单元结构复杂、占用硅片面积大、单位容量成本高,且缩放已接近极限——在台积电5纳米到3纳米制程演进中,计算单元可缩小约1.6倍,SRAM单元面积却仅减少约5%。悬殊的对比十分直观:Groq 3约500MB的SRAM容量,与英伟达Rubin GPU单颗288GB HBM4相比,仅为后者的1/500水平;若要用LPU单独运行万亿参数级超大模型,需要将数千颗芯片并联,芯片级token处理效率会大幅下降。英伟达目前的过渡性对策是系统级互补——让Groq3 LPX机架与Vera Rubin GPU通过Spectrum-X互连配对,带宽极高的LPU负责前馈网络层运算,GPU负责需要大键值内存的注意力层。而下一代芯片直接转向3D堆叠DRAM,则是在芯片层面扩大容量、突破SRAM瓶颈的尝试。
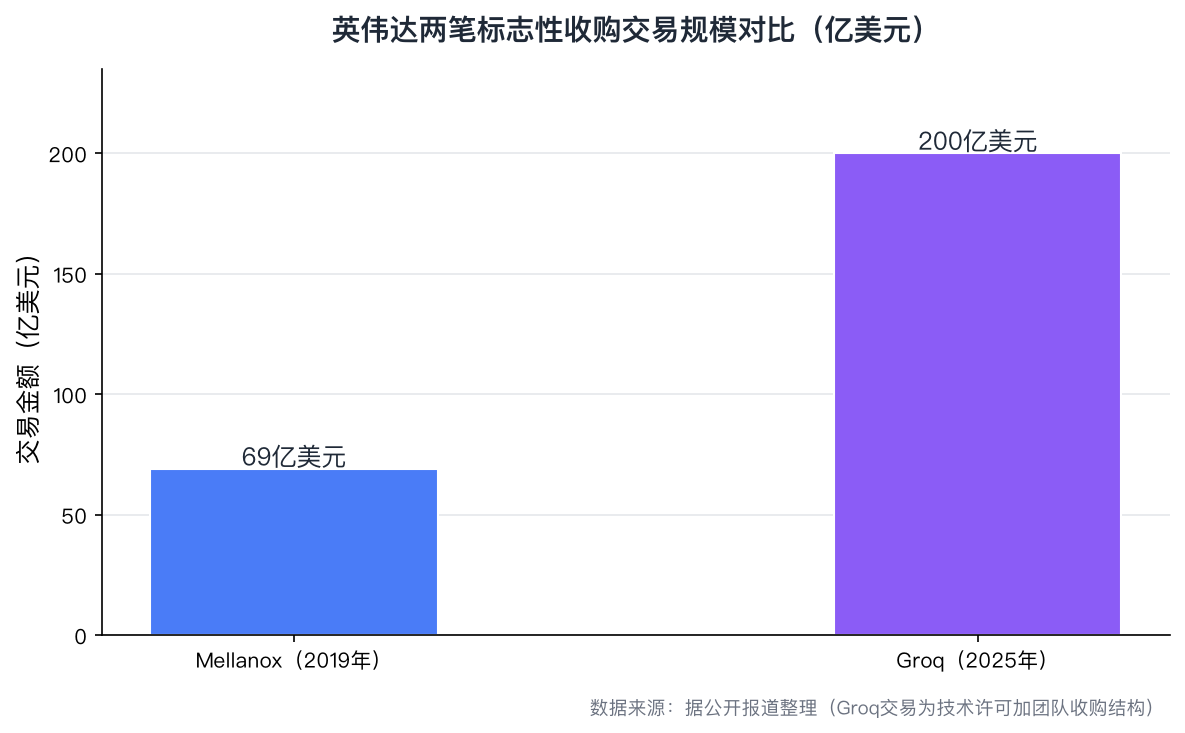
【图表:英伟达两笔标志性收购交易规模对比】
图表解读:从69亿美元的Mellanox到200亿美元的Groq,英伟达最大收购纪录被刷新近两倍——推理时代的战略重要性,已与当年网络互连技术处于同一量级。
大SRAM流派的集体转身:三家公司的同一选择
Groq的转向并非孤立事件,而是一场行业共识的缩影。
同样以大SRAM路线著称的Cerebras,已在Hot Chips 2026上预告:未来的CS-6系统将首次引入晶圆级3D堆叠,把DRAM层通过超高带宽垂直互连置于逻辑与SRAM晶圆之上,在保持近存计算低延迟优势的同时突破仅靠SRAM扩容的瓶颈。据其官方技术博客,CS-6通过将晶圆级SRAM与算力和3D堆叠DRAM集成,旨在“不牺牲晶圆级速度所带来的局部性优势”的前提下大幅扩展内存容量;这家公司还同步公布了Nexus系统架构与多代路线图——2027年的CS-5目标为每用户每秒10000个token的生成速度,CS-6则将首次把DRAM直接堆叠在计算晶圆之上。
AI推理芯片公司d-Matrix走得更早。2025年11月,d-Matrix与Alchip宣布合作开发全球首个面向AI推理的3D堆叠DRAM解决方案,称其推理速度最高可达HBM4方案的10倍;其Raptor方案采用台积电N4逻辑裸片与3D DRAM裸片面对面堆叠的架构,在硅面积基准对比中单位面积带宽达32.6GB/s/mm²,约为HBM4和英伟达Rubin R200的20倍,每GB/s带宽功耗仅2.96毫瓦、较HBM方案改善13.5倍,单卡带宽超过100TB/s。其首席执行官明确表态:“这不是传统的HBM方案。”而在系统产品端,其现役Corsair加速器已配置2048个数字内存计算核心、150TB/s性能内存带宽与最高256GB容量内存。
三家大SRAM流派代表不约而同奔向同一方向——从SRAM独扛,转向“SRAM+3D堆叠DRAM”的混合内存层级。
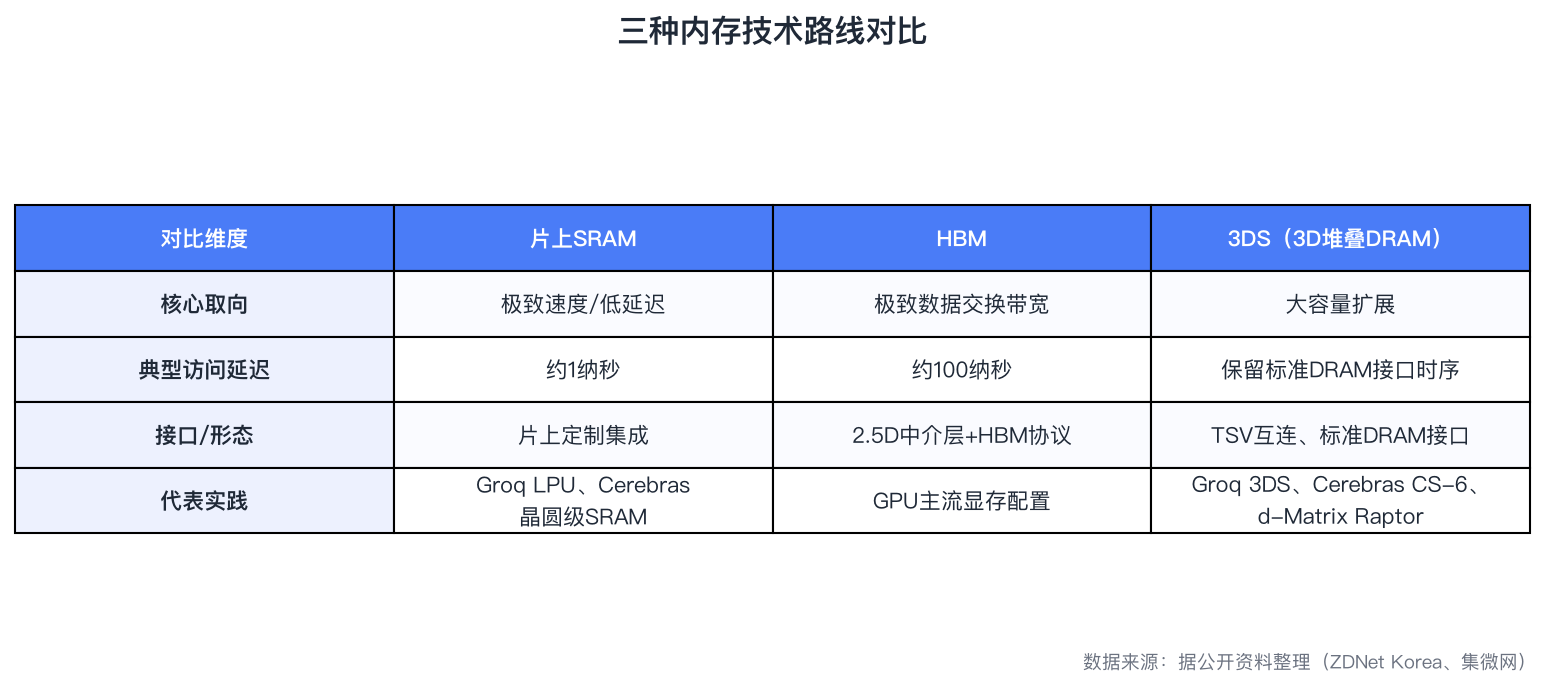
【图表:三种内存技术路线对比图】
图表解读:DRAM虽然原生读写速度略逊于SRAM,但其大容量特性在复杂模型部署中更具优势——对于必须载入海量参数的AI推理任务,3DS在保持标准DRAM接口协议的前提下专注容量扩张,是比HBM更务实的降本增效方案。
背后的逻辑并不复杂。整个市场都在朝“更大的芯片”方向演进,选择容量更强的DRAM正是顺应这一趋势;更深层看,HBM的速度红利正逼近物理极限,行业此前的共同选择是“把SRAM做大”——英伟达在Rubin设计阶段便已大幅扩充片上SRAM容量、最大化运算单元带宽。但SRAM的密度增益终究追不上模型参数的膨胀速度:在台积电5纳米到3纳米制程演进中,计算单元可缩小约1.6倍,SRAM单元面积却仅减少约5%。当SRAM扩容遇到天花板,3D堆叠DRAM便成为“近存计算”与“大容量”之间的最优解:既保住低延迟,又装得下模型。ZDNet Korea援引另一位业界人士的分析称,整个市场都在朝“更大的芯片”方向演进,Groq选择容量更强的DRAM正是顺应这一趋势。
产业影响:推理时代的内存层级重构
把这次架构转向放进更大的产业图景,能看到三层意义。
其一,推理正在定义新的竞争规则。生成式AI的快速发展使推理成为新的竞争前沿——推理更强调吞吐量、延迟和能效,这推动了谷歌TPU等ASIC芯片的崛起,自2025年以来TPU出货量大幅增长。Groq的LPU架构强调高速token输出与实时响应能力,与GPU形成互补;据韩国im证券分析,LPU可实现较传统GPU快约10倍以上的响应速度、能效高出90%以上,其确定性调度设计还能让多芯片互联后如单一巨大核心般工作。拿下Groq,等于英伟达在推理新战场上提前修筑了防线。
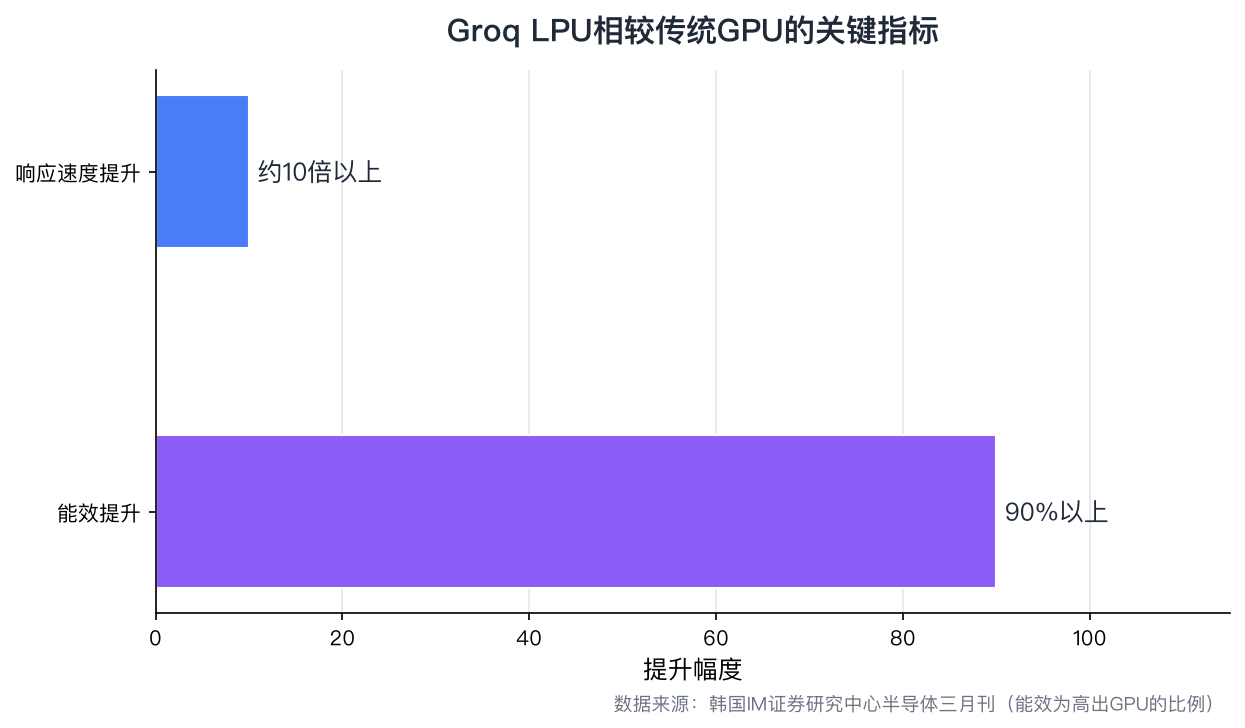
【图表:Groq LPU相较传统GPU的关键指标】
图表解读:约10倍以上的响应速度与高出90%以上的能效,是LPU在低延迟推理场景立足的根本——而下一代架构要守住这两项指标,正是转向3D堆叠DRAM的最大挑战。
其二,内存层级走向混合化。英伟达通过Groq的技术可构建“大容量数据由HBM/DRAM承担、实时高速运算由SRAM承担”的混合内存架构——这与HBM领域的定制化趋势相互呼应:英伟达8月发布的NVHBM定制HBM同样将内存控制器下沉到基底裸片,GPU、HBM、SRAM与3D堆叠DRAM的分工边界正在被重新绘制。值得注意的是,Groq3 LPU芯片目前由三星4纳米工艺代工,黄仁勋在GTC 2026上公开确认“三星正在为我们制造Groq3芯片”;供应链人士指出,Groq现有芯片本就在三星4纳米生产,当前合作只是延续既有产品线。
其三,生态话语权的争夺延伸到了存储标准。3DS保留标准DRAM接口的设计,意味着它可以接入成熟的DRAM生态而不必另起炉灶;若Groq下一代芯片成功验证这一路线,“SRAM做计算级缓存+3D堆叠DRAM做容量层”或将成为推理芯片的参考架构,对DRAM厂商、TSV封装产能乃至HBM供需都是新的变量。
未来展望:混合内存层级时代的三个观察点
展望下一代Groq芯片,有三个观察点值得关注。其一,3DS方案的量产时间表与良率——TSV在DRAM内打穿数千微孔的工艺复杂度不低,容量与速度的平衡能否兑现“守住速度优势、补齐容量短板”的预期,尚待实测;其二,混合内存层级在软件栈上的实现难度——从SRAM独扛到SRAM与3D DRAM协同,编译器与调度策略需要重写,这正是LPU“确定性执行”理念的用武之地,也是最大的工程风险;其三,英伟达的自研节奏——其自研3纳米基底裸片与定制HBM(NVHBM)已在推进,Groq的3DS路线与之如何协同,将决定英伟达“GPU+LPU+定制存储”全家桶的完整度。
更大的图景是:当推理算力占据全球AI基础设施的七成以上,存储——而非算力——正在成为AI芯片创新的主战场。从HBM4的混合键合,到NVHBM的定制基底,再到Groq的3DS,一条清晰的演进线索浮现出来:谁能用最低的能耗把最大的模型“装进离计算最近的存储里”,谁就掌握了AI推理时代的定价权。英伟达与Groq的这次架构转向,只是这场战争的最新一枪。